中国信通院联合联想等发布《面向智能体能力构建的高质量数据集建设指南(2026年)》。报告提出一个关键判断:基础大模型解决“知道什么”,行业模型解决“懂什么”,智能体数据集解决的是“如何完成任务”。训练数据的定义,正在被改写。
过去几年,高质量数据集建设的核心逻辑相对清晰:尽可能多地汇聚文本、图像、语音等静态样本,覆盖更广的知识面,保证更高的准确性。这套逻辑支撑了大模型从“会聊天”到“有知识”的跃迁。
但当AI从“回答问题”走向“执行任务”,这套逻辑开始不够用了。智能体需要的不是“知道什么”,而是“在具体情境下,先做什么、再做什么、遇到异常怎么调整、调用哪个工具、结果不对如何回退”。这些能力难以通过静态语料“读”出来,更多需要通过过程数据“练”出来。
10月28日,中国信通院人工智能研究所联合联想、中国人工智能产业发展联盟数据委员会发布的这份《面向智能体能力构建的高质量数据集建设指南(2026年)》(以下简称“指南”),正是对这一变化的系统性回应。
智能体数据集的核心,
不是“内容”,是“过程”
指南给出了一个直白的区分:传统大模型数据集以静态样本为主,核心价值在于“知识覆盖”;智能体数据集的核心,则是记录“任务—决策—行动—反馈”完整闭环过程。
这意味着数据形态发生了实质性扩展。除基础文本和图像外,智能体训练还需要大量推理链、工具调用轨迹、时序状态、反馈纠错等过程类数据。一条有价值的数据,不再只是“一段话对应一个标签”,而是一条包含目标、输入、环境状态、决策依据、工具调用、执行结果和修正动作的完整轨迹。
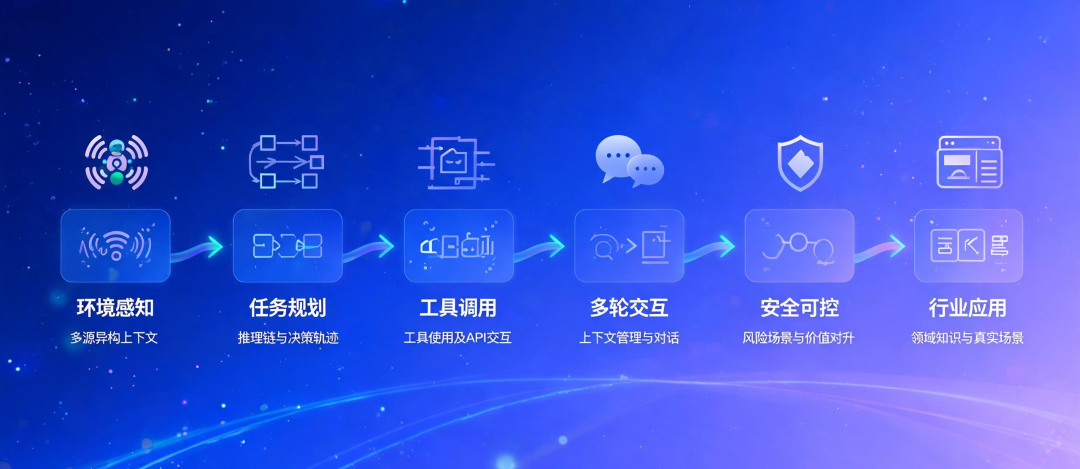
指南将智能体能力拆解为六大维度,每一维对应一类过程数据:环境感知需要多源异构上下文,任务规划需要推理链与决策轨迹,工具调用需要工具使用及API交互数据,多轮交互需要上下文管理与对话数据,安全可控需要风险场景与价值对齐数据,行业应用需要领域知识与真实场景数据。
六类数据不是并列关系,而是支撑智能体从“感知”到“规划”再到“执行”的能力链条。
TalkingData洞察
数据集的价值锚点正在从“内容覆盖”转向 “过程支撑” 。过去评价一个数据集,看的是它“包含了多少知识”;未来评价一个智能体数据集,看的是它“能让智能体在多大程度上把任务跑通”。这对数据服务行业的影响是直接的:通用语料的溢价空间在收窄,而任务轨迹、决策链、工具交互记录这类过程数据的采集、清洗和结构化能力,正在成为新的竞争维度。
质量评估换了标尺:
不看指标,看表现
与数据形态变化同步发生的,是质量评估逻辑的迁移。
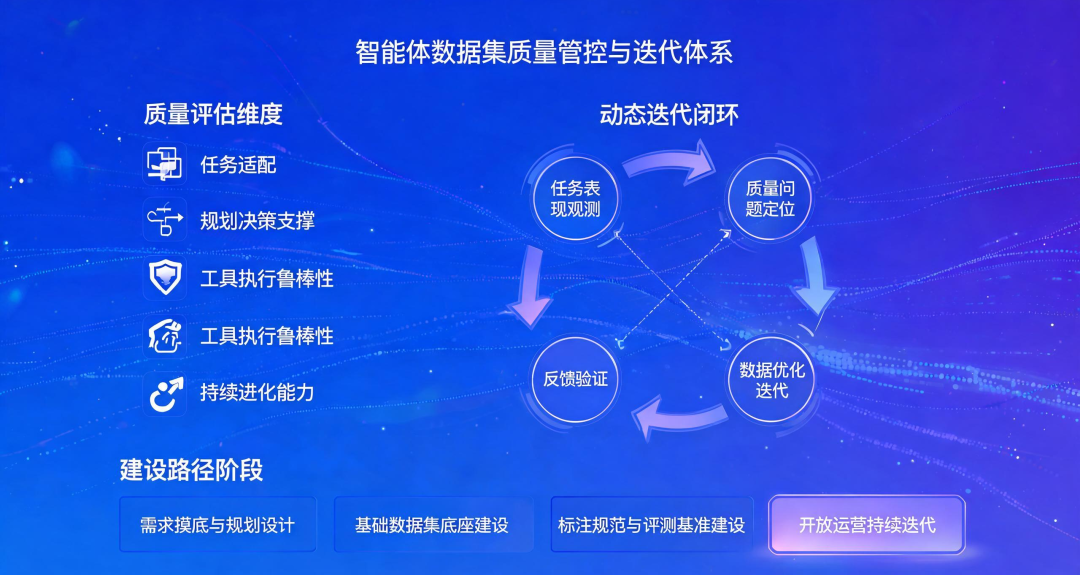
传统数据集的质量评估,围绕完整性、准确性、一致性等静态指标展开。指南明确提出,面向智能体能力构建的数据集,质量评估需要新增任务适配、规划决策支撑、工具执行鲁棒性、持续进化能力等专属维度,并将智能体的实际应用表现与数据质量评估相结合——通过任务表现观测、质量问题定位、数据优化迭代和反馈验证,形成闭环,推动质量管理由静态评估向动态迭代演进。
换句话说,一个智能体数据集“好不好”,不再只由数据集本身的属性决定,还要看它在真实任务中“管不管用”。
指南将建设路径归纳为四个阶段:需求摸底与规划设计、基础数据集底座建设、标注规范与评测基准建设、开放运营持续迭代。
其中“开放运营持续迭代”被单独列出,说明数据集正在从“一次性交付的产品”变成“需要持续运营的服务”。
TalkingData洞察
“动态迭代”这四个字,对数据服务行业的商业模式含义很深。
如果数据集的价值需要通过任务表现来验证,并且需要持续迭代来维持,那么一次性交付、按量计价的模式将越来越难以匹配客户需求。能够嵌入客户业务流程、持续观测数据在任务中的表现、并据此迭代优化数据集的服务商,将获得更强的客户粘性和更稳定的收入结构。数据集交付的终点,正在从“验收”变成“运营”。
对数据服务行业意味着什么:
能力栈需要重新排列
指南披露的产业背景值得关注:
全球智能体市场预计从2024年的51亿美元增长到2030年的471亿美元,年复合增长率44.8%;
国内通用平台与行业专用双轨并进,政策提出打造100个工业领域高质量数据集、推广500个典型应用场景、培育1000个高水平工业智能体。
与此同时,数据供给在规模、质量、结构和标准化程度上仍难以充分匹配智能体快速发展的需求。
供给与需求之间的落差,恰恰是数据服务行业的机会所在,但机会的分布并不均匀。
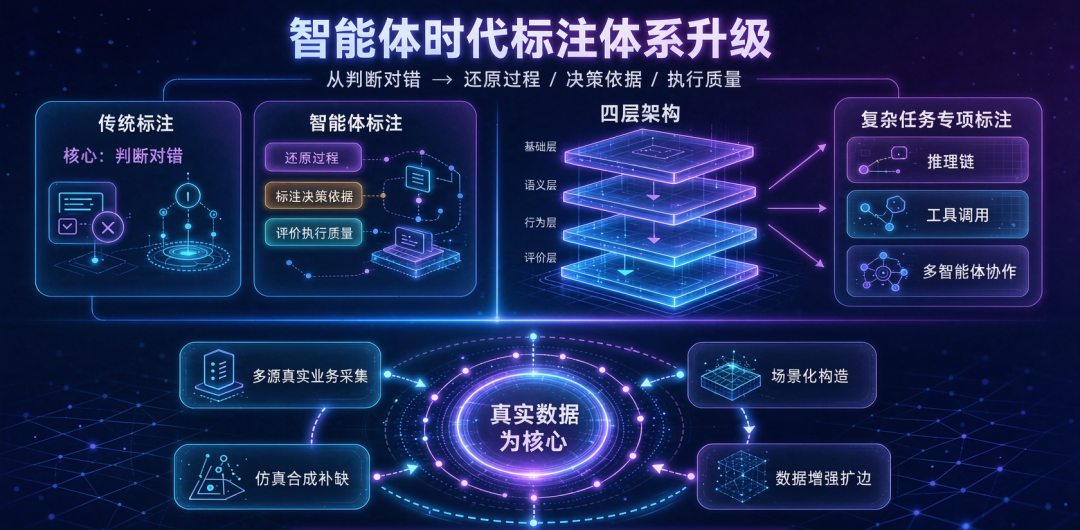
指南在标注体系上提出了基础层—语义层—行为层—评价层四层架构,并针对推理链、工具调用、多智能体协作等复杂任务给出专项标注方案。这与传统标注的作业方式有本质区别:传统标注的核心是“判断对错”,智能体标注的核心是“还原过程、标注决策依据、评价执行质量”。
数据来源结构也在变化。数据来源包括多源真实业务采集、场景化构造、仿真合成补缺和数据增强扩边,但合成数据只能作为补充,不能完全替代真实数据。
这意味着一家只能提供合成数据或通用语料的服务商,在智能体数据供给中的位置会被压缩;而那些能够深入真实业务场景、获取过程轨迹、并具备行为层和评价层标注能力的服务商,将获得更稀缺的供给位置。
TalkingData洞察
智能体数据集对数据服务行业提出的,不是“再多标一点”的量的要求,而是能力栈重新排列的要求。
采集环节需要覆盖工具调用和操作轨迹,标注环节需要能够处理推理链和行为评价,交付环节需要支持持续迭代——这三个环节的能力,传统以静态语料为主的服务商并不天然具备。能够率先完成从“内容标注”向“过程标注”能力迁移的服务商,将在智能体数据供给的早期格局中占据先发位置。
结语
训练数据的定义,正在从“知识”扩展到“过程” 。基础大模型需要知道世界是什么样的,智能体需要知道事情是怎么做成的。前者靠语料,后者靠轨迹。
对数据服务行业而言,这意味着一个需要正视的现实:过去积累的通用语料能力和标注产能,并不能自动迁移到智能体数据供给中。过程数据的采集、行为层的标注、任务表现的验证、持续迭代的运营——每一项都需要重新建设能力。
但换一个角度看,这也意味着一个窗口期。智能体数据供给的标准化才刚刚开始,行业格局远未定型。能够在“任务—决策—行动—反馈”这条闭环上建立起可验证的采集、标注和迭代能力的服务商,有机会在下一阶段的数据供给体系中占据一个比今天更有利的位置。
免责声明:
本文基于中国信息通信研究院、联想(北京)有限公司、中国人工智能产业发展联盟公开发布的《面向智能体能力构建的高质量数据集建设指南(2026年)》及公开报道撰写。文中分析观点为基于公开信息的独立判断,不代表任何官方立场。
END
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撑。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享