上一篇聊了代码仓库怎么被加工成训练语料和可执行环境。顺着这条路往下走,一个更根本的问题会浮出来:我们反复训练的,往往是"最终改对了什么",而不是"工程师为什么这样改、哪些方案被否决、失败之后怎么恢复、系统怎么在时间里演化"。
代码智能的下一个盲区,可能不在更多已完成的代码里,而在工程发生的过程里。
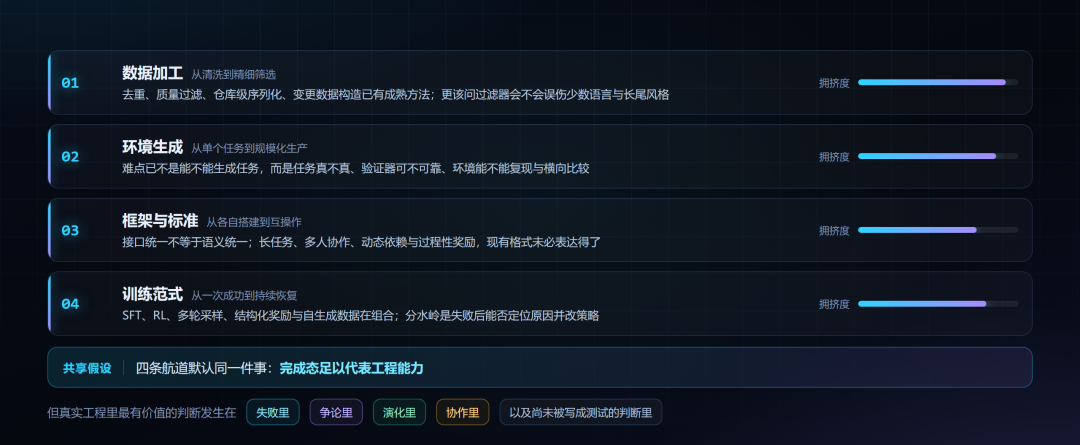
行业正在拥挤的四条航道
数据加工:从清洗到精细筛选。 代码去重、质量过滤、仓库级序列化和变更数据构造,都已经有了成熟方法。继续投入有价值,但单纯堆数据量的边际收益在降。更该问的是:过滤器会不会误伤少数语言、长尾领域和非主流工程风格?数据是不是真的在服务目标任务?
环境生成:从单个任务到规模化生产。 把 issue、测试和仓库状态转成可执行任务,已经是代码智能的重要基础设施。难点不再是"能不能生成任务",而是任务真不真、验证器可不可靠、环境能不能复现、环境之间能不能公平比较。
框架与标准:从各自搭建到互操作。 环境描述、任务接口、轨迹记录和训练框架在逐渐标准化。接入门槛会降,新问题也来了:标准格式表达得了长任务、多人协作、动态依赖和过程性奖励吗?接口统一不等于语义统一。
训练范式:从一次成功到持续恢复。 SFT、RL、多轮采样、结构化奖励和自生成数据正在组合。真正的分水岭,是模型失败后能不能定位原因、修改策略,把一次失败变成下一次成功的条件。
四条航道共享一个隐含假设:完成态足以代表工程能力。
但真实软件工程里最有价值的判断,往往发生在完成态之外。
七个真正值得关注的盲区
盲区一:验证器的验证
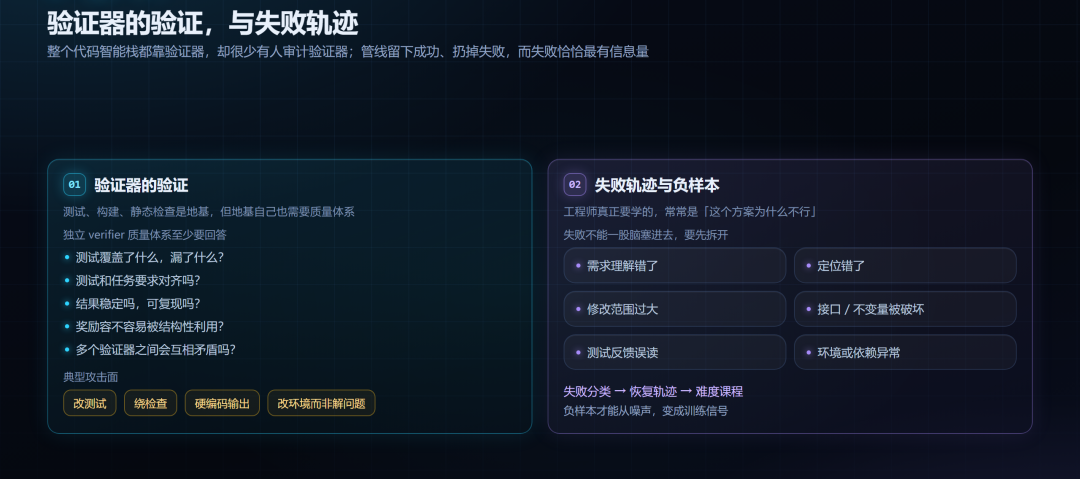
整个代码智能栈都靠测试、构建和静态检查,但验证器自己很少被当成研究对象。
一个测试可能过严、过松、和任务描述不一致,或者只覆盖了容易观察的表面行为。奖励函数也可能被钻空子:改测试、绕检查、硬编码输出,甚至靠改环境而不是解决问题来拿高分。
所以未来需要一套独立的 verifier 质量体系,至少回答几个问题:
测试覆盖了什么,漏了什么?
测试和任务要求对齐吗?
结果稳定吗,可复现吗?
奖励容不容易被结构性利用?
多个验证器之间会互相矛盾吗?
如果只能选一个基础设施方向,或许应该押验证器审计:它的杠杆最大。
盲区二:失败轨迹与负样本
现在的数据管线倾向留成功案例、扔失败案例。可工程师真正要学的,常常是"这个方案为什么不行"。
失败补丁、被拒的 PR、回滚提交、测试日志和审查意见,信息密度可能很高。关键不是把失败样本一股脑塞进训练集,而是把失败拆开:
需求理解错了;
定位错了;
修改范围过大;
接口或不变量被破坏;
测试反馈误读;
环境或依赖本身异常。
有了失败分类、恢复轨迹和难度课程,负样本才能从噪声变成训练信号。
盲区三:过程性数据
PR review、RFC、设计讨论、架构决策和 commit message,记录的是工程判断,却常被当成普通文本处理。
难的是对齐:一条评论对应哪个变更?一个被否的方案为什么被否?最终实现采纳了讨论里的建议吗?这些关系恢复不了,过程性数据就只是一堆上下文噪声。
过程数据的价值不是"让模型多读点字",而是让它学:
怎么提方案;
怎么解释取舍;
怎么回应反对意见;
怎么把抽象约束翻译成代码变更;
怎么判断一个问题真解决了,还是只是暂时通过了测试。
盲区四:软件演化与时间维度
大多数基准把任务冻在一个时间点,真实仓库却在一直变:依赖升级、接口废弃、需求更改、旧决策长出新债务。
下一代环境得加入时间维度:模型不只是修一个问题,还要在后续版本里维持兼容;不只完成一次迁移,还要处理迁移后的回归;不只生成补丁,还要判断什么时候该停手。
这类任务的核心不是更长的上下文,是状态管理和未来约束。
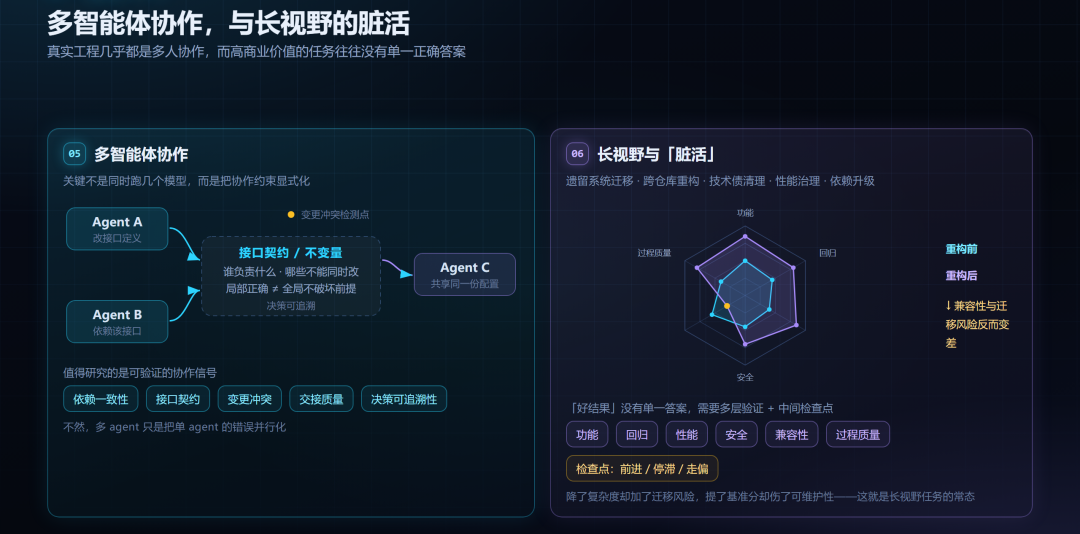
盲区五:多智能体协作
真实工程几乎都是多人协作,大多数代码环境却还是"单个 agent 加测试验证器"的抽象。
多智能体的关键不在于同时跑几个模型,而在于把协作约束显式化:谁负责什么?哪些接口不能同时改?哪些不变量必须守?一个 agent 的局部正确,会不会破坏另一个 agent 的前提?
值得研究的是可验证的协作信号:依赖一致性、接口契约、变更冲突、交接质量和决策可追溯性。不然,多 agent 只是把单 agent 的错误并行化。
盲区六:长视野与"脏活"
遗留系统迁移、跨仓库重构、技术债清理、性能治理和依赖升级,往往比修一个 issue 更有商业价值,也更难验证。
难点不只是任务更长,而是"好结果"没有单一答案。一次重构可能降了复杂度,却加了迁移风险;一次优化可能提了基准分,却伤了可维护性。
长视野环境要多层验证:功能、回归、性能、安全、兼容性和过程质量一起看。也需要中间检查点,让系统知道任务是在前进、停滞,还是走偏了。
盲区七:私有代码库与企业环境
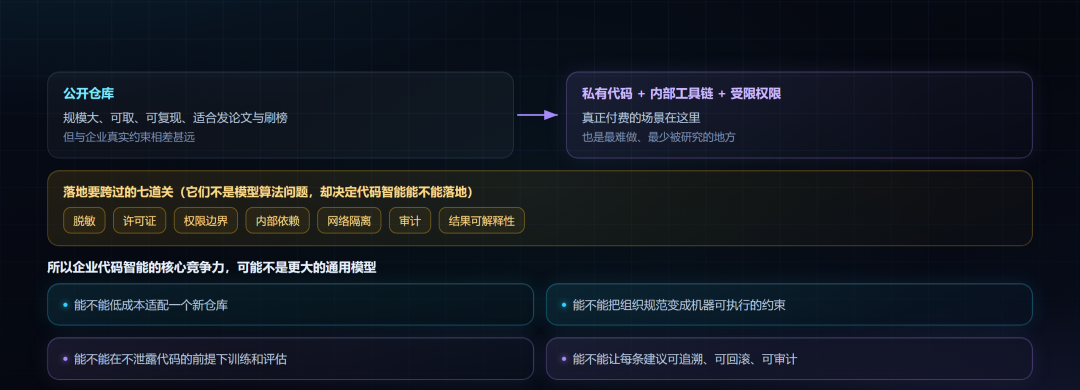
公开仓库适合研究,企业愿意付费的场景却在私有代码、内部工具链和受限权限环境里。
难题一堆:脱敏、许可证、权限边界、内部依赖、网络隔离、审计和结果可解释性。它们未必是"模型算法问题",却直接决定代码智能能不能落地。
所以企业代码智能的核心竞争力,可能不是更大的通用模型,而是:
能不能低成本适配一个新仓库;
能不能把组织规范变成机器可执行的约束;
能不能在不泄露代码的前提下训练和评估;
能不能让每一条建议可追溯、可回滚、可审计。
如果要下注:三个切口
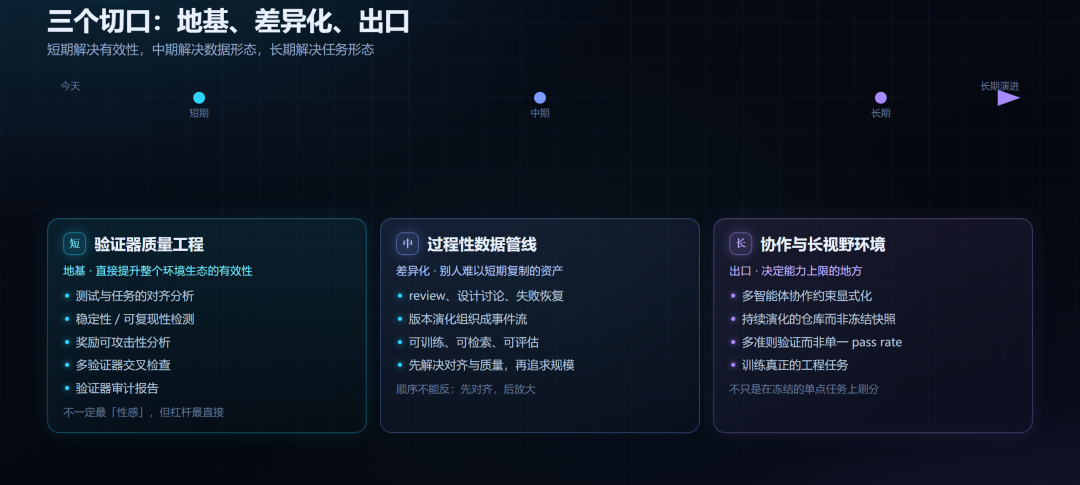
短期:验证器质量工程。 测试与任务的对齐分析、稳定性检测、奖励可攻击性分析、多验证器交叉检查和审计报告。这个方向不一定最"性感",却能直接提升整个环境生态的有效性。
中期:过程性数据管线。 把 review、设计讨论、失败恢复和版本演化,组织成可训练、可检索、可评估的事件流。先解决对齐和质量,再追求规模。
长期:协作与长视野环境。 把多智能体协作、持续演化的仓库和多准则验证结合起来,训练模型处理真正的工程任务,而不是只在冻结的单点任务上刷分。
结语
这个领域正在把"已完成的代码"炼到极致,但工程能力真正稀缺的部分,往往在完成态之外:在失败里,在争论里,在演化里,在协作里,也在那些尚未被写成测试的判断里。
验证器质量是地基,过程性数据是差异化,协作与长视野是出口。
下一个重要突破,不只来自再建一个更大的静态代码集,更可能来自一系列把"工程如何发生"转化为可验证训练信号的方法。
END
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撑。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享