代码大模型的竞争,正在换赛道。
以前比谁的参数更多、训练技巧更花。现在比谁的数据更好、环境更真、验证信号更靠谱。代码仓库被推到台前,不是因为它规模大,而是它把需求、设计、实现、测试、评审和迭代,全压在了一条可追溯的链路上。
GitHub 不应只当成"代码下载站",它更像一座能被重新编译的训练基础设施:仓库可以加工成语料,可以改造成任务环境,最后还可能变成模型自我改进的反馈回路。
这篇文章主要谈三件事:仓库怎么被炼成训练资源,行业在争什么,下一阶段的瓶颈在哪。
先说结论
两条主线:仓库 → 训练语料;仓库 → 可执行、可验证的任务环境。
一个关键变化:数据工程和环境工程正在合流,训练样本不再只是文本,而是带着上下文、执行结果和反馈的轨迹。
瓶颈有四个:验证器可不可靠,环境真不真实,模型是在推理还是在背答案,以及整套玩法成本上能不能扛住。
为什么偏偏是代码仓库
代码仓库的独特之处,不是"代码比文本更高级",而是它同时具备四种训练价值。
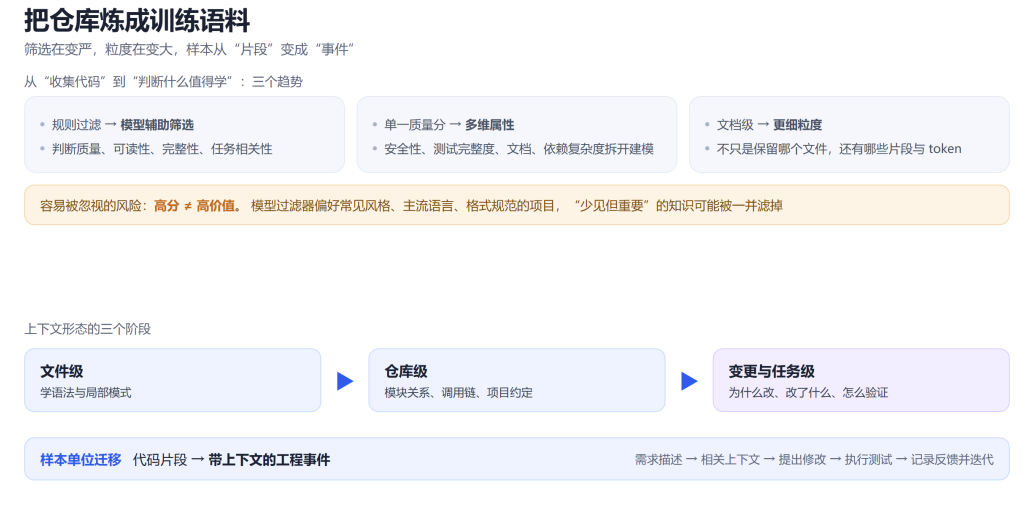
可执行。 代码能编译、能运行、能测试、能部署。测试通过当然不等于真的写对了,但它至少给了你一个比纯文本明确得多的信号。拿它做监督学习样本可以,做强化学习的奖励和拒绝信号也可以。
自带上下文。 一个真实任务很少是一段孤立代码,它由 issue、讨论、提交、评审、测试和文档共同组成。仓库因此提供了一条从"问题是什么"到"为什么这样改"的完整链路。
记录了演化过程。 commit、branch、PR、release 把软件的演化存了下来。模型学到的就不只是最终状态,还有变更前后、失败与回滚,以及一个方案怎么被一步步修正。
跨文件、跨模块依赖。 真实仓库逼着模型处理接口、不变量、依赖关系和版本兼容,而不是只生成一个局部函数。这正是代码智能从"补全"走向"工程代理"必须补的一课。
所以仓库的价值可以用一句话概括:它同时给了你规模、结构、过程,和一部分可验证性。
主线 A:把仓库炼成训练语料
从"收集代码"到"判断什么值得学"
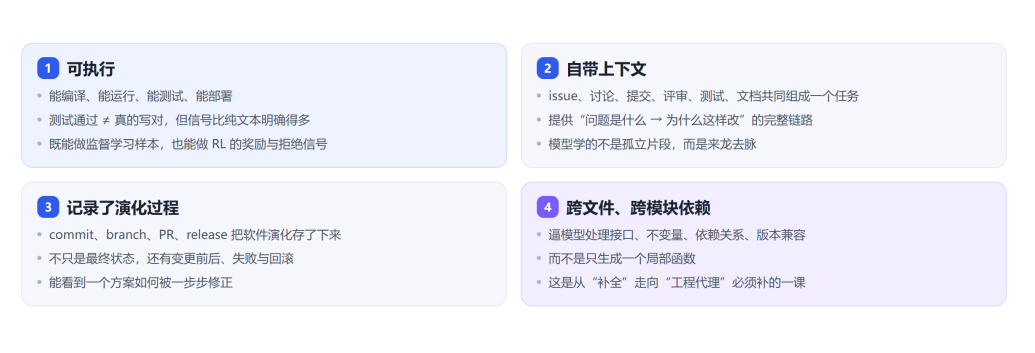
早期的数据处理很简单:去重、卡长度、认语言、洗格式。现在越来越强调"可学习性":这段代码完整吗?包含有用的工程模式吗?文档和实现一致吗?对哪些任务真有帮助?
由此会有三个趋势:
从规则过滤转向模型辅助筛选,用模型或分类器判断质量、可读性、完整性和任务相关性;
从单一质量分转向多维属性,把安全性、测试完整度、文档质量、依赖复杂度拆开建模;
从文档级筛选转向更细的粒度,不只决定"保留哪个文件",还要决定"保留哪些片段、哪些 token、哪些上下文"。
但有个风险容易被忽视:高分真的等于高价值吗?
模型驱动的过滤器会偏好常见风格、主流语言、格式规范的项目,"少见但重要"的知识很可能被一并滤掉。数据质量从来不是一个绝对分数,它跟目标任务、模型规模和训练阶段都有关。
从文件级样本到仓库级样本
代码模型的上下文形态,正在经历三个阶段:文件级 → 仓库级 → 变更与任务级。
文件级样本适合学语法和局部模式;仓库级样本让模型学模块关系、调用链和项目约定;变更与任务级样本更进一步,提供了"为什么改、改了什么、怎么验证"的工程语境。
高价值的序列化方式,通常不是把所有文件拼起来,而是围绕任务组织上下文:
先给问题描述或需求;
提供相关目录、接口和历史变更;
让模型提出修改;
执行测试、静态检查或构建;
记录反馈,继续迭代。
训练样本的基本单位,正在从"代码片段"变成"带上下文的工程事件"。
PR、commit 与 issue:天然的工程轨迹
真实仓库里最有价值的样本,往往不是最终代码,而是变更链路:
issue 说明问题和约束;
PR 描述拟议方案;
review 记录争议与取舍;
commit 展示实现过程;
CI 和测试提供反馈;
merge、revert 或 follow-up issue 记录结果。
把这些对齐好,能生成远比"代码对注释"丰富的训练数据。难点也在这:时间线可能不完整,一条评论可能对应多个文件,最终合并的代码未必等于任何一次单独提交,测试也可能覆盖不足。
工程数据的价值,取决于关联质量,不只是数量。
主线 B:把仓库炼成可验证的任务环境
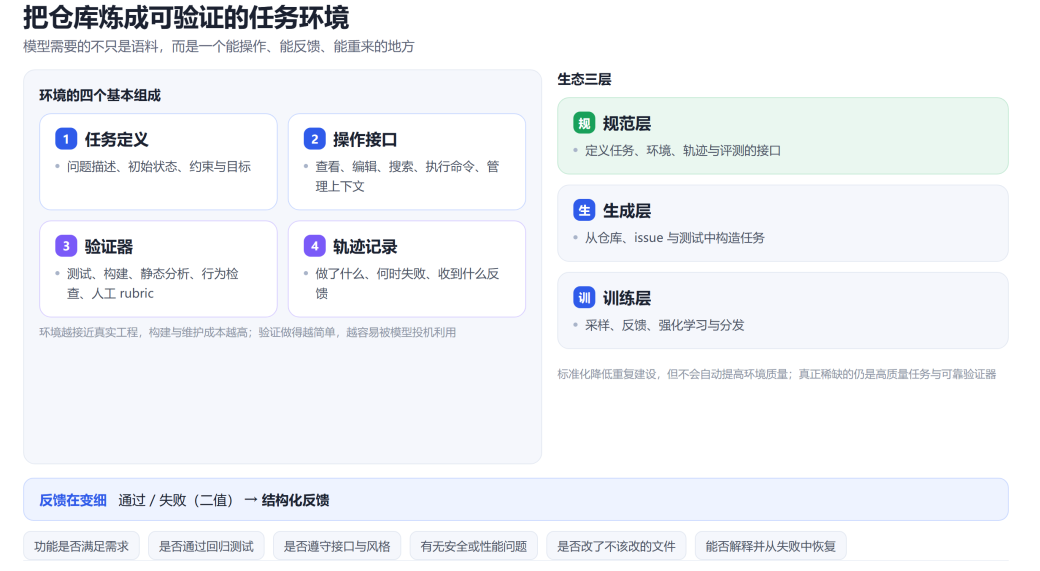
现在模型不再只是生成代码片段,它要执行多步行动,完成真实任务。光喂静态语料肯定不够。它需要一个能操作的环境:能读仓库、编辑文件、跑命令、看到反馈,失败了还能重来。
环境的基本组成
环境生成正在标准化
从二值奖励到结构化反馈
训练范式正在怎样迁移
SFT 不够用了
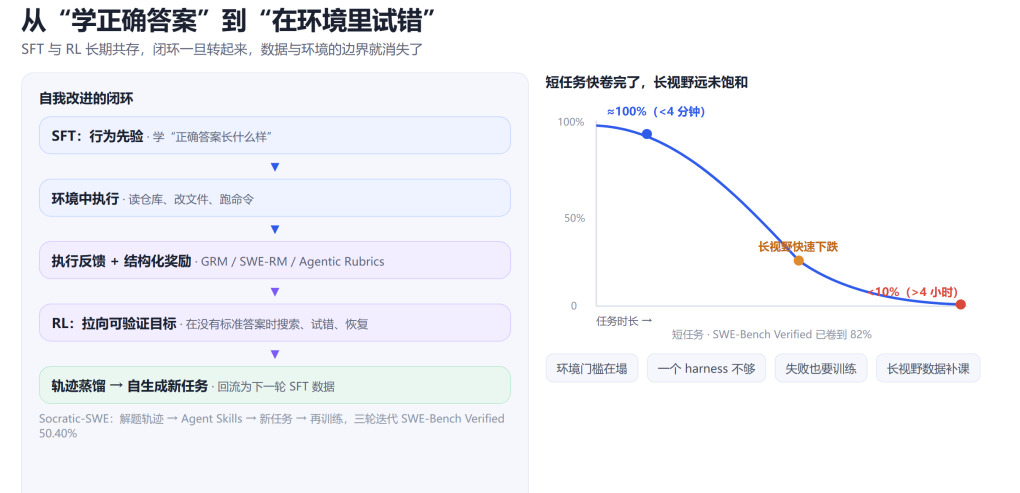
监督微调擅长学“正确答案长什么样”,强化学习能用执行反馈,训练模型在没有标准答案时搜索、试错和恢复。两者更可能长期共存:SFT 提供稳定的行为先验,RL 负责把行为拉向可验证的目标。
阿里和上交的 Socratic-SWE 把这条路走成了闭环:解题轨迹蒸馏成 Agent Skills,技能反向生成新任务,新任务再拿去训练。三轮迭代,SWE-Bench Verified 50.40%。数字本身不算惊艳,但它说明一件事:数据生成和环境生成的边界,开始消失了。
奖励在变细
“通过/失败”适合快速筛选,指导不了复杂任务。一个补丁可能通过了部分测试,却破坏了接口;也可能功能是对的,但违反了性能、安全或兼容性约束。
奖励正在从“过不过”变成“哪里做得好”。GRM 用人类设计的 rubric 给中间行为打分;SWE-RM(ICLR 2026)拿一个 30B MoE 奖励模型,把“执行无关的轨迹评分”和“执行信号”混着用,RL pass@1 涨了 3 个点;Scale Labs 的 Agentic Rubrics 更激进,让专家 agent 自己生成 rubric 清单。
环境门槛在塌
以前搭一个可训练环境是重活:容器、依赖、快照,一搞就是几天。SWE-MiniSandbox 把成本打到了地板上。门槛一降,环境就能批量造,竞争焦点也随之转移:不再是“谁能搭起来”,而是“谁的验证器更可靠、谁的任务更难投机”。
一个 harness 不够
单一脚手架容易被过拟合,也框死了 agent 的行为方式。Lego-RL 让 Claude Code、OpenHands、OpenCode 各自保留控制流,在 verl 里混合训练;MiniMax Forge 更宽松,任意黑盒脚手架都能接。
未来更可能是多 harness 、多种测试套件组合:单元测试、集成测试、静态分析、差分测试、依赖自动检查加人工抽检,共同构成反馈。
短任务快卷完了
补全函数、修单个 issue 这类短任务已经相对成熟,SWE-Bench Verified 卷到 82%。真正难的是跨模块重构、依赖升级、迁移、性能优化和连续迭代,它们要更长的上下文、更好的状态管理和更可靠的中间检查点。
METR 的测量很直白:4 分钟以内的任务接近 100%,超过 4 小时的任务不足 10%。长视野远没有饱和。
数据端在跟上。Triadic Data 主张补三类长视野数据:人-人工程对话、人-AI 会话、跨职能多周工作。
训练端,NVIDIA 的 FC-SWE 用“失败条件 RL”:把失败补丁和验证器反馈作为恢复轨迹的上下文,专门训练失败恢复。Qwen3.5-4B Resolved@1 到 41.7%,试到第 11 次能到 70.7%。
热闹背后的四个冷问题
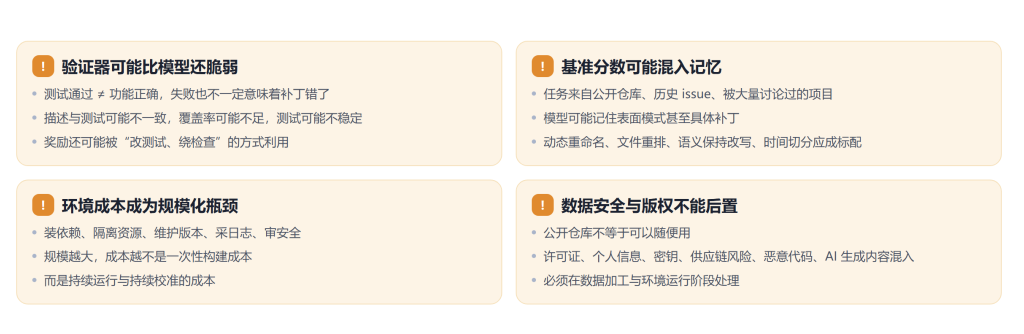
1、验证器可能比模型还脆弱。 测试通过不等于功能正确,测试失败也不一定意味着补丁错了。问题描述和测试可能不一致,覆盖率可能不足,测试可能不稳定,奖励还可能被"改测试、绕检查"的方式利用。
所以下一阶段要研究的不只是"怎么生成更多 verifier",还有:verifier 的覆盖范围、对齐程度、稳定性和可被攻击性,该怎么评估?
2、基准分数可能混入记忆。 任务如果来自公开仓库、历史 issue 或被大量讨论过的项目,模型可能记住了表面模式甚至具体补丁。动态重命名、文件重排、语义保持的改写和时间切分,应该成为评测设计的标配。
3、环境成本会成为规模化瓶颈。 环境要装依赖、隔离资源、维护版本、采日志、审安全。规模越大,成本越不是一次性的构建成本,而是持续运行和持续校准的成本。
4、数据安全与版权不能后置。 公开仓库不等于可以随便用。许可证、个人信息、密钥、供应链风险、恶意代码、AI 生成内容混入,都得在数据加工和环境运行阶段处理,不能等训练完了再补救。
未来 1年,值得盯的五个方向
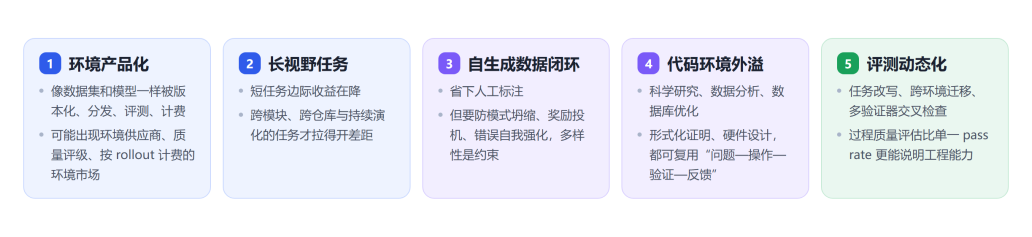
环境会产品化,甚至会出现专门的环境市场。 环境会像数据集和模型一样被版本化、分发、评测、计费。当"环境"成为可标价、可交易、可组合的资产,可能会出现专门的环境供应商、环境质量评级、乃至按 rollout 次数计费的环境市场。
长视野任务会是分水岭。 短任务的边际收益在降,跨模块、跨仓库和持续演化的任务才拉得开差距。
自生成数据会闭环,多样性是约束。 模型自己生成任务、轨迹和反馈,能省人工标注;但也可能模式坍缩、奖励投机、错误自我强化。数据多样性、外部审计和动态任务生成会越来越重要。
代码环境会外溢。科学研究、数据分析、数据库优化、形式化证明和硬件设计,都可能复用"问题、操作、验证、反馈"这套框架。
评测会从静态分数转向动态与对抗。 任务改写、跨环境迁移、多验证器交叉检查和过程质量评估,会比单一 pass rate 更能说明模型是否真正具备工程能力。
代码仓库的角色在变:它不再只是被读取的原料,开始同时成为训练数据、任务环境、验证器和反馈回路。竞争也因此迁移:从"谁拥有更多代码",变成"谁能把代码组织成更可靠、更丰富、更难投机的学习过程"。
模型能力可以参数化,工程能力必须环境化。所以这行接下来真正该盯的,恐怕不是谁的静态代码库更大,而是一个更糙的问题:失败的过程,到底怎么喂给模型?
END
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撑。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享