全球高质量真实物理交互数据总量仅约50万小时,而训练通用具身模型至少需要1000万小时——数据量不足实际需求的5%。当模型架构趋于成熟、算法能力趋于接近,数据的质量和精度正在成为决定AI能力上限的关键变量。
2026年,AI产业的竞争逻辑正在发生一次深层转变。
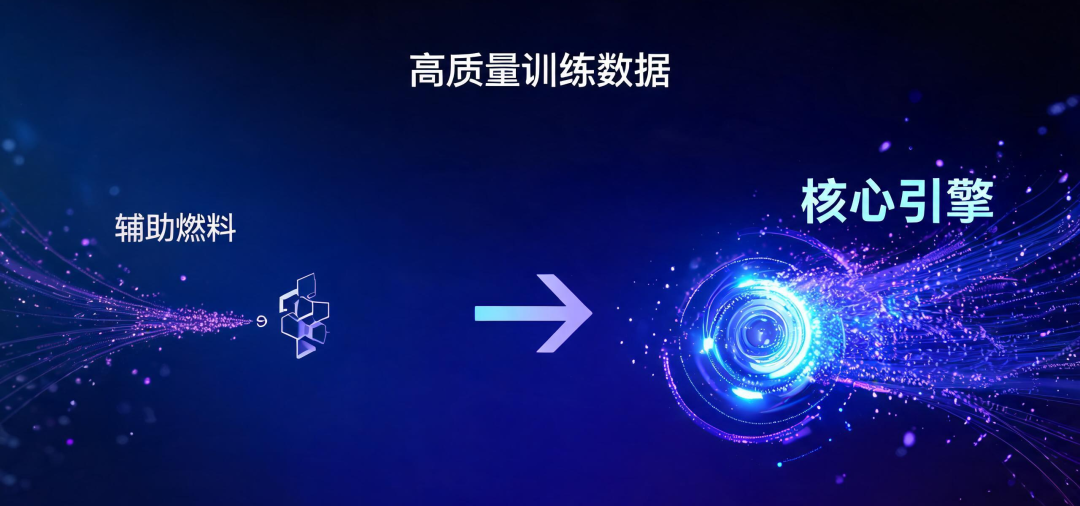
随着主流大模型陆续开源、模型训练成本下降,高质量训练数据正在从“辅助燃料”升级为决定模型能力上限的“核心引擎”。这一判断正在被多个行业数据和案例所印证。
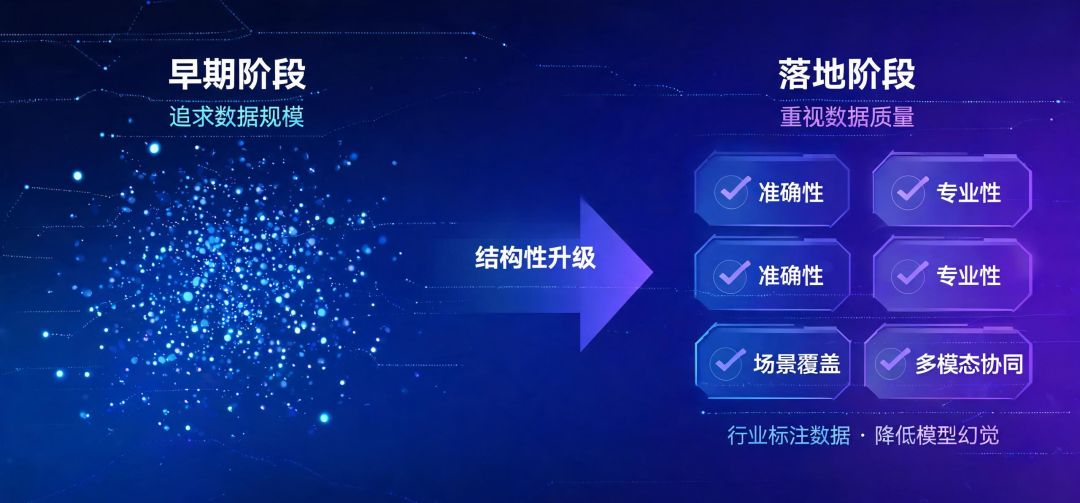
数据需求的“结构性升级”
大模型早期训练更强调数据规模,进入后训练和垂直场景落地阶段后,数据的准确性、专业性、场景覆盖度和多模态协同能力变得更加重要。医疗、金融、工业、自动驾驶等领域不仅需要通用语料,还需要经过清洗、标注和质量控制的行业数据,以提高模型推理可靠性、降低幻觉率。
据Epoch AI 2026年Q1报告,可公开获取的高质量文本数据预计将在2027年被AI训练耗尽。全球互联网上可公开获取的高质量文本数据总量约为500万亿Token,按照当前大模型训练数据的增长速度,将在2027-2028年被全部耗尽。
当“数据”从可简单获取的原料转变为决定模型上限的稀缺生产要素,高质量语料的稀缺性反而有所加剧。
TalkingData洞察
数据需求的“结构性升级”意味着,数据服务行业的竞争逻辑正在改变。过去比拼的是“谁能提供更多数据”,现在比拼的是“谁能提供更准确、更专业、更贴合场景的数据”。数据集的价值评估正在从“体量导向”转向“质量导向”——能够针对特定行业场景提供高质量标注数据的服务商,将获得更大的议价空间。
具身智能:数据缺口超过95%
具身智能进一步扩展了“训练数据”的边界。机器人需要理解并作用于真实物理世界,训练数据因而从文本、图像和语音,延伸至动作轨迹、力反馈、物体形变以及人与环境的交互过程。
据国金证券2026年7月发布的研报显示,截至2026年初,全球高质量真实物理交互数据总量仅约50万小时,而训练通用具身模型至少需要1000万小时的多模态交互数据,当前数据量不足实际需求的5%。
中国信通院发布的《具身智能训练场研究报告(2026年)》也指出,当前全球可用的高质量真实数据仅为数十万至百万小时级,而具身基础模型要迎来“ChatGPT时刻”至少需要数千万小时数据,缺口超过99%,远未达到支撑能力涌现的临界点。
复旦大学长聘特聘教授张立华指出,全球范围内研发端对高质量数据的需求量约为120万小时,而全行业每月数据产出量仅为25万—30万小时。互联网上几乎不存在现成的、能够直接映射到机器人感知与控制链路上的“多模态指令—动作”数据集——“我们面临的不是数据的优化,而是从零开始的原始积累”。
TalkingData洞察
具身智能的数据缺口,本质上是数据服务行业能力边界的一次扩展。过去数据服务主要面向文本、图像和语音,而具身智能要求数据服务商具备物理交互数据的采集、标注和质量控制能力——这需要完全不同的技术栈和场景理解能力。谁能在这一领域率先建立能力,谁就能在下一阶段的AI数据服务市场中占据先机。
数据标注产业:
从“通用服务”走向“行业定制”
高质量数据的稀缺,正在推动数据标注产业的结构性升级。
在2026中国国际大数据产业博览会上,数据标注成为热门议题。2025年用于AI训练和推理的数据量是199.48EB,其中推理数据101.34EB已经超过训练数据,“这说明AI产业的重心正在从把模型练出来转向了让模型每天进入客服、制造、营销、科研和公共服务领域”。
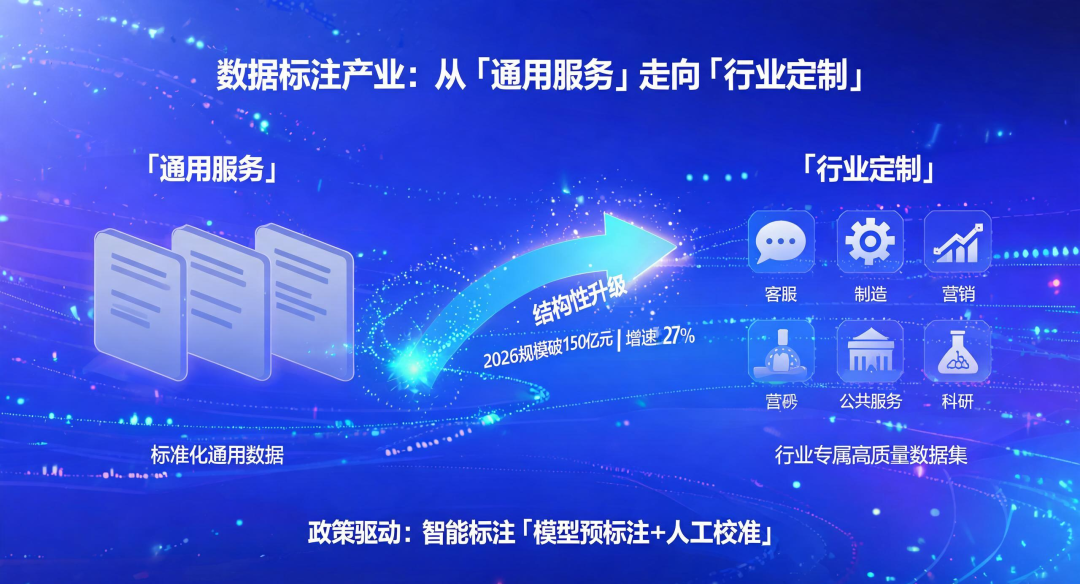
产业规模也在快速增长。中国数据标注行业市场规模从2018年的25.86亿元增长至2025年的117.53亿元,年复合增长率达24.15%。据测算,2026年同比增速将超27%,整体规模突破150亿元。
国家数据局此前印发的《关于推进行业高质量数据集建设行动的实施方案》,明确提出发展“模型预标注+人工校准”“人工标注+模型检验”等智能化标注服务,全面提升数据标注水平。
政策与市场的双重驱动下,数据标注正在从“通用服务”走向“行业定制”。
TalkingData洞察
数据标注产业的增长,反映的是AI从“通用”走向“垂直”的现实需求。不同行业、不同场景对训练数据的要求差异巨大——医疗数据需要专业知识、工业数据需要场景理解、具身智能数据需要物理交互能力。能够在垂直场景中建立标注能力的服务商,将获得更大的市场空间。
结语
从Epoch AI关于高质量文本数据将在2027年被耗尽的预测,到具身智能领域超过95%的数据缺口,再到数据标注产业年复合增长率超过24%的市场扩张——高质量语料的稀缺性正在从“行业共识”变为“产业现实”。
当模型架构趋于成熟、算法能力趋于接近,数据的质量和精度正在成为决定AI能力上限的关键变量。
对于数据服务行业而言,这意味着一个清晰的信号:能够提供高质量、场景化、多模态数据服务的企业,将在AI产业从“以模型为中心”向“以数据为中心”的转变中,获得更大的发展空间。
免责声明:
本文基于国金证券、中国信通院、Epoch AI等机构公开发布的研究报告及公开行业数据撰写。文中分析观点为基于公开信息的独立判断,不代表任何官方立场。具体数据请以各机构最新发布为准。
END
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撑。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享