TalkingData × WeToken联合发布 | 洞察模型能力进化新高度
看懂大模型竞争的两大核心:通用底座 + 垂直能力
AI大模型,正推动智能技术进入广泛赋能的新阶段。基座模型夯实智能基础,垂直模型解锁场景价值:技术深化与场景渗透双轨并行。
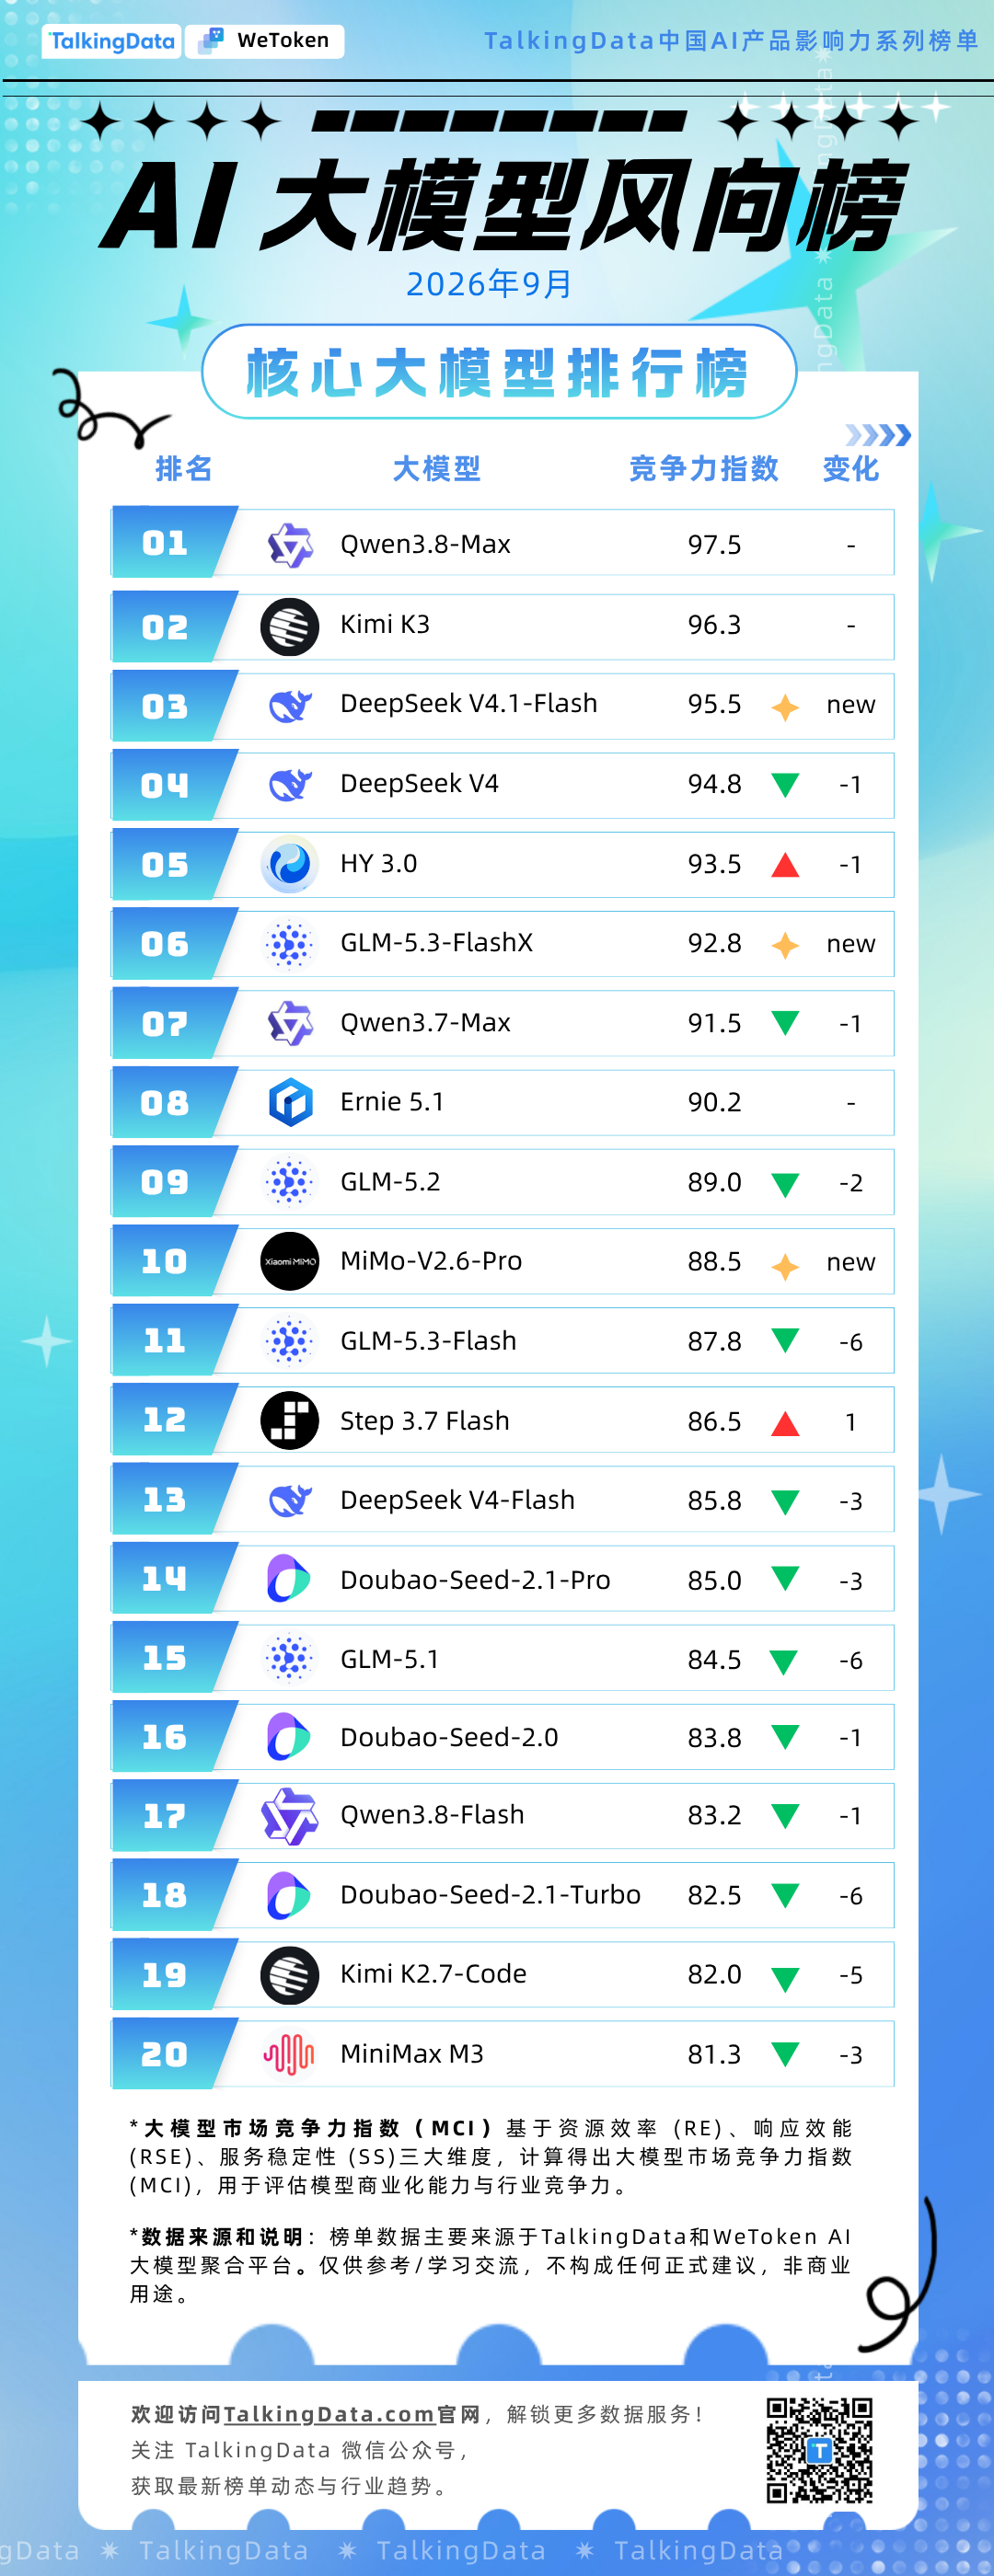
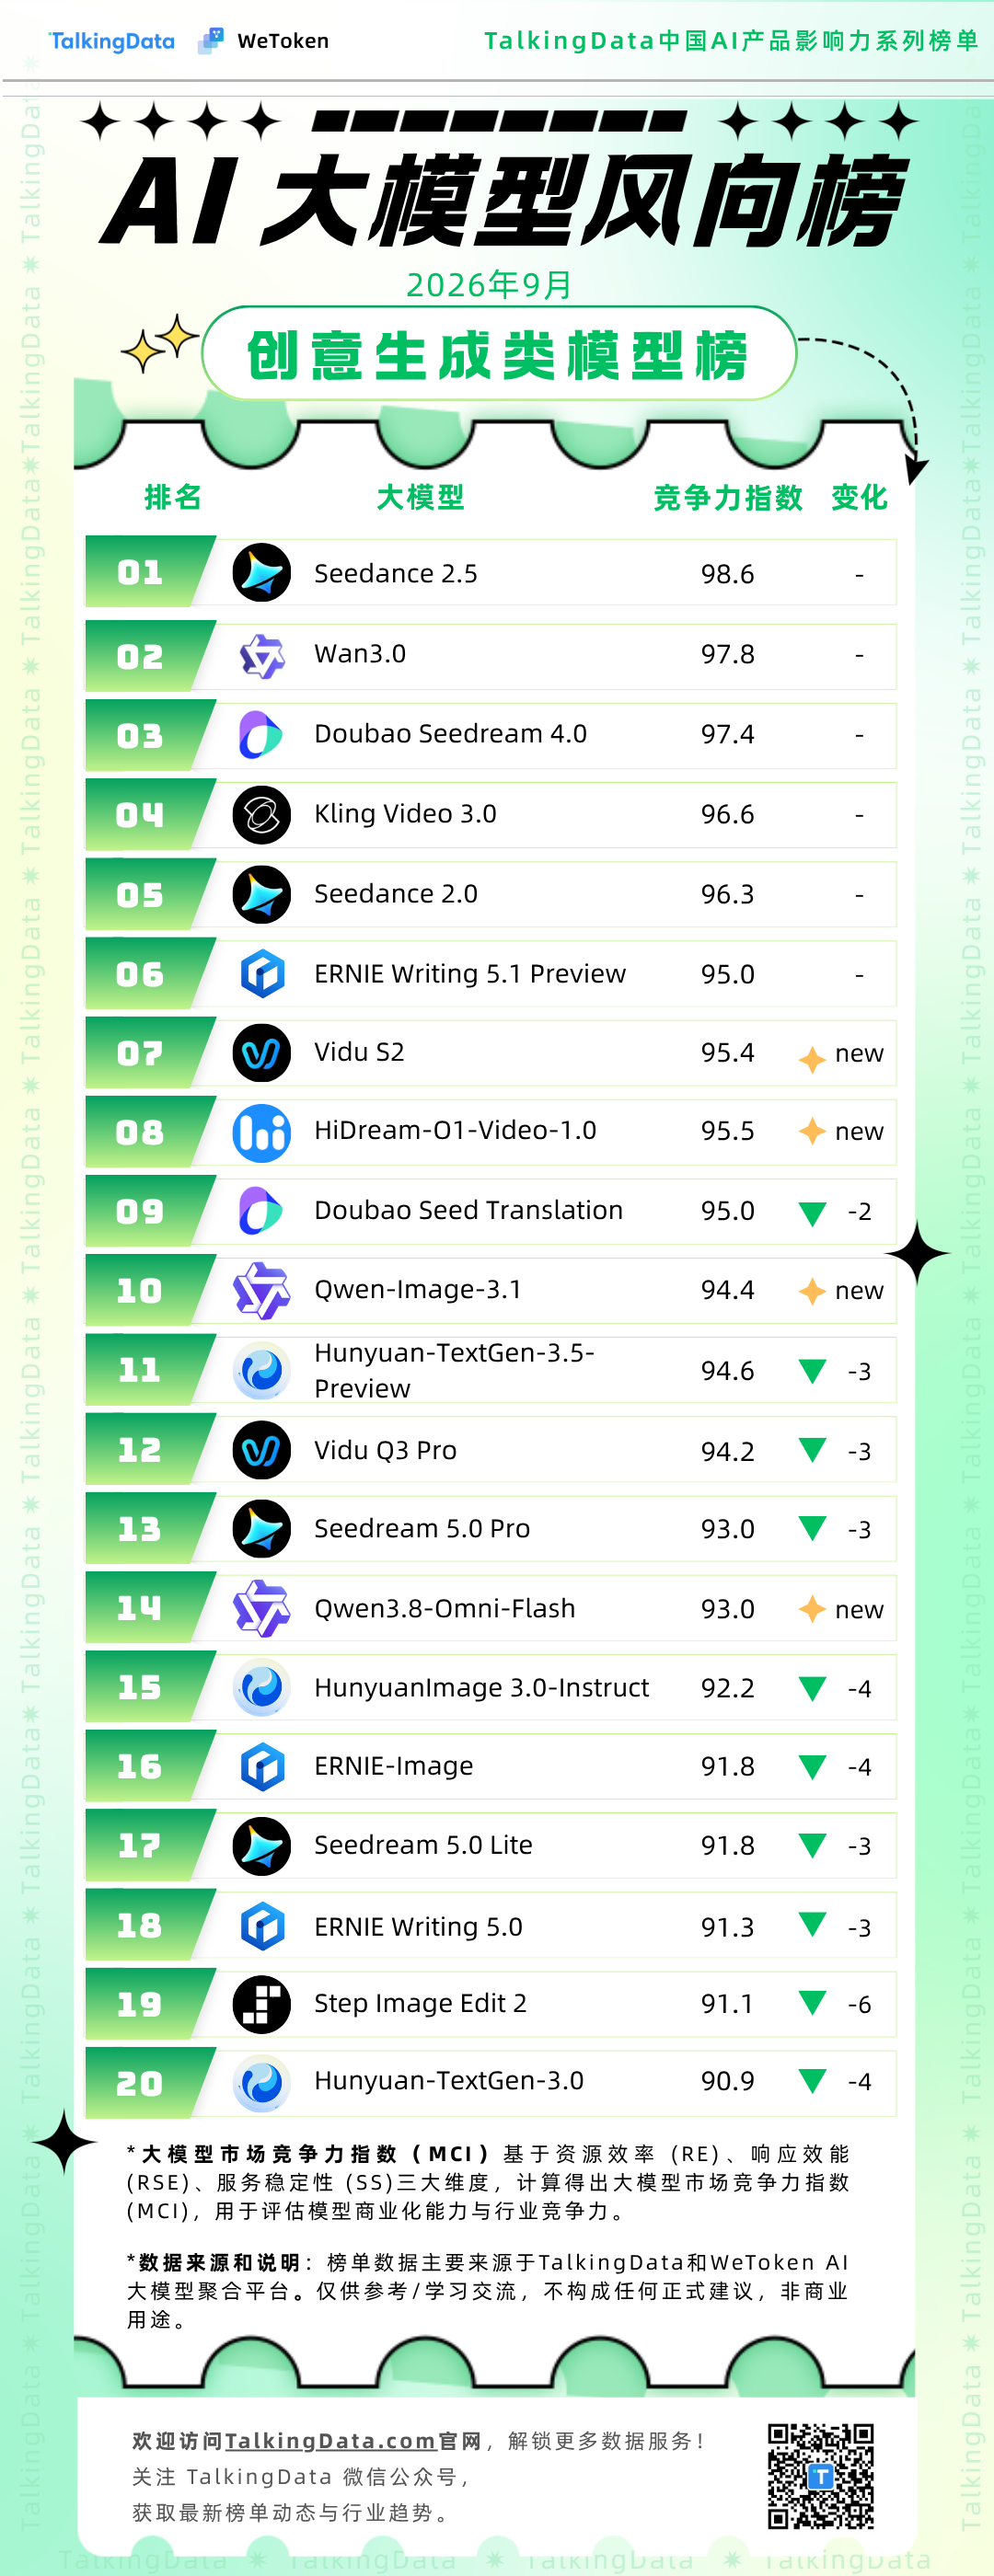
基于TalkingData和WeToken AI大模型聚合平台数据,推出《AI大模型风向榜》,持续追踪驱动模型进化的两股核心力量。设两大榜单:核心大模型榜,聚焦模型的综合通用能力与基座性能;创意生成类模型榜,衡量模型在垂直内容创作场景下的专精表现。为行业提供客观、动态的数据参考。
榜单核心看点:
核心大模型榜:聚焦效能优化与原生多模态
本期核心榜中,DeepSeek V4.1-Flash、GLM-5.3-FlashX、MiMo-V2.6-Pro 等新进入榜单的模型,在技术路线上呈现出两个较为清晰的方向。
在架构层面,以更低激活成本实现高效能,成为新模型的共同选择。 DeepSeek V4.1-Flash 采用非对称架构,总参数量552B,但输入仅激活8B、输出激活16B;GLM-5.3-FlashX 总参数量320B、激活参数18B,并采用稀疏注意力与线性注意力混合架构,注意力计算量和KV缓存相比上一代分别降低约3倍和4.4倍。可以看出,本期新模型不再单纯追求参数规模,而是将能效比作为核心优化目标。
在能力层面,原生多模态正在成为新模型的标配。 DeepSeek V4.1-Flash 具备原生多模态视觉理解能力;GLM-5.3-FlashX 原生支持视频、图像、文本与文件输入,并将视觉能力融入Coding循环,可主动观察界面与渲染结果;MiMo-V2.6-Pro 支持文本、图片、视频、音频全模态输入,最长上下文窗口达100万Token。这意味着,多模态不再是附加功能,而是从模型设计之初就被纳入基础能力。
创意生成类模型榜:从“生成内容”转向“交互与理解”
与核心榜侧重效能优化不同,创意类新模型更明显地指向创作工作流的深化。
视频生成方向,正在从“生成一段内容”向“实时交互与编辑”延伸。 Vidu S2 包含两个模型方向:S2-Avatar 将实时数字人输出提升至720P,并支持互动过程中随时更新参考图;S2-Editing 面向持续输入的视频流,可实时改变画面中的风格、服装、人物和背景。这反映出视频模型开始进入“可交互、可编辑”的阶段。
与此同时,视频生成也开始强调对物理规律与用户意图的建模。 HiDream-O1-Video-1.0 采用原生全模态架构,将重力、碰撞、惯性等物理规律融入生成过程,同时在生成前先对用户输入进行结构化规划,包括镜头时长、场景构图、运镜焦段等。
图像生成方向,则出现了更明确的生产力场景定位。 Qwen-Image-3.1 面向科研图示、营销图片和电影分镜等场景,提出多维编辑能力,核心目标是减少随机性、增加确定性,使图像生成在专业场景中的可用性得到提升。
全模态模型开始以“完成任务”为核心目标。 Qwen3.8-Omni-Flash 支持1M长序列与文本、图像、音频、视频同框输入,定位从“理解全模态内容”走向“规划任务、调用工具并完成创作”,在视频剪辑、音视频转图文摘要等工作流中展开应用。
趋势洞察:
模型竞争的重心正从“参数规模”向“架构效能”迁移。
本期多款新模型不再以参数规模作为核心卖点,而是通过非对称架构、稀疏与线性注意力混合、MoE稀疏化等路线,在降低激活成本的同时保持较高的能力水平。能效比正在成为衡量模型竞争力的重要维度。
创意生成赛道的关键词从“生成质量”扩展为“交互与理解”。
Vidu S2 的实时编辑能力、HiDream-O1-Video-1.0 的物理规律建模、Qwen-Image-3.1 的确定性编辑,共同指向一个趋势:创意模型不再只是“输出内容”,而是开始理解用户的创作意图和物理世界的约束条件。
全模态正在从“能力标签”转变为“产品基础”。
本期核心榜和创意榜的新模型几乎都具备原生多模态输入能力,区别在于如何将多模态能力与具体任务结合。部分模型聚焦Agent执行,部分聚焦创作工作流,多模态的差异化正体现在场景落地的深度上。
9月大模型榜单的新面孔,在技术路线上呈现出一些共性的选择:更高效的架构、更原生的多模态、更贴近具体任务的定位。这些方向上的差异,或许比排名本身更值得持续关注。
榜单数据说明
1、数据来源和指标:
本榜单数据主要来源于TalkingData和WeToken AI大模型聚合平台,基于资源效率 (RE)、响应效能 (RSE)、服务稳定性 (SS)三大维度,计算得出大模型市场竞争力指数 (MCI),用于评估模型商业化能力与行业竞争力。
3、数据周期
2026年9月
引用和转载声明:
本文所涉数据及相关分析内容,版权均归TalkingData所有。任何个人或机构如需转载、引用相关内容,需获得TalkingData的授权,并在使用时明确注明来源。未经许可,不得用于商业用途。
数据免责声明:
TalkingData 发布的所有数据、榜单、报告及相关分析内容(以下简称“数据内容”)均基于公开信息、市场监测及自有模型测算得出。数据内容旨在反映特定条件下的市场趋势与特征,仅供业界参考与交流之用,不构成任何形式的投资建议、业务决策依据或事实承诺。
TalkingData 力求数据内容的客观与严谨,但不对其准确性、完整性或时效性作任何明示或暗示的保证。任何个人或机构依据本数据内容所做的判断与行动,其相关风险及后果需自行承担。
TalkingData 保留对数据内容及其最终解释的所有权利。
关注TalkingData,获取更多数据洞察与行业分析。
END
高质量数据集是未来AI 发展的支撑。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享