近日,阿里巴巴 CEO 吴泳铭在内部信中宣布,将成立以“创造、输送、应用 Token”为核心的全新事业群。至此,一个清晰的信号向行业传来:AI 竞赛的主战场,正从模型能力的单点较量,转向以Token为血液的“生产力生态”构建。
2026 年 3 月,技术圈被两股浪潮席卷。一边是以“自主思考、主动执行”引爆社区的 AI 项目,在 GitHub 上狂揽数十万星标,其重度用户日均消耗可达上亿 Token,单日成本轻松突破数千美元。另一边,阿里启动近年来最重要的组织变革,成立与云、电商并行的 Alibaba Token Hub(ATH)事业群,将核心 AI 业务全线整合,瞄准 Token 的全链路布局。
当最初的技术兴奋逐渐退潮,一个现实问题浮出水面:这太烧钱了。
普通开发者的账单变得触目惊心,运行一个长期在线的智能体,月度 Token 消耗可达数十亿,成本近万元人民币。
“我可能不是在养智能体,是在养一只吞金兽。”类似的吐槽在社区中不绝于耳。
无论是个人开发者试水,还是企业部署应用,Token 的消耗速度与成本控制,已成为横亘在创新与规模化之间最现实的“高墙”。 智能体“永远在线”的模式不断推高算力需求,将“成本透明化”这一深水区问题,推至聚光灯下。
当 Token 成为AI应用不可或缺的新血液,其指数级增长的消耗与难以承受的成本,正迅速演变为整个行业必须共同面对的“不可承受之重”。
01
从“偶尔用”到“全天候”
算力消耗的指数级跃迁
要理解AI智能体为什么“烧钱”,得先理解它的运行逻辑。
传统AI对话模型的工作方式是“即用即走”:用户输入问题,模型给出答案,一次交互结束。就像一个点餐的顾客,来了点单,吃完走人。
但以Openclaw、Manus、腾讯WorkBuddy、字节ArkClaw等为代表的执行型智能体完全不同。它们的运行逻辑是“主动唤醒→检查环境→自主推理→执行动作→循环往复”。开发者可以给它设定一个目标,比如“每天早上帮我整理行业新闻”,它就会像一个永不休息的数字员工,全天候待命,定时执行任务。
这种模式被称为“智能体永动模式”。它带来的算力消耗,与传统AI完全不在一个量级。

IDC最新发布的一份白皮书给出了惊人数据:智能体算力消耗的年度Token复合增长率高达3418%。如果说传统AI是偶尔点一杯咖啡,智能体就是永远开着的水龙头。
OpenRouter平台的统计数据直观反映了这一变化。作为全球最大的AI模型聚合平台,OpenRouter记录了每一款应用的Token消耗。数据显示,OpenClaw累计Token消耗量已达8.52万亿,稳居平台应用流行度榜首。
这个数字意味着什么?相当于让GPT-4连续不断地回答2.1亿个复杂问题,或者生成超过10万部《三体》三部曲的文字量。
02
“养智能体”的成本账
重度用户日均耗资过万
更触目惊心的是个体消耗数据。
据开发者社区不完全统计,部署并长期运行复杂AI智能体的重度用户,日均Token消耗量在数千万至上亿之间。
一位在社交媒体晒账单的用户写道:“我的智能体平均每天消耗5000万Token,按主流模型的价格算,一天就是数百美元,一个月下来能买一台顶配MacBook。”
另一位用户则选择了性价比路线,改用国产模型API。“成本确实降下来了,一天大概几十美元。”但他也坦言,“但心里还是没底,不知道它什么时候会突然跑起来,也不知道它会跑多久。”
这种“成本黑盒”效应,正在成为智能体普及的最大心理障碍。
方正证券在一份研报中指出,算力成本失控是企业采用智能体的核心顾虑之一。一位受访企业CTO直言:“我不敢让智能体自主运行太久,万一它跑偏了,一个晚上烧掉我一个月预算怎么办?”
这种担忧并非杞人忧天。Anthropic最新发布的一份智能体行为实测报告显示,Claude已能独立完成需人类近5小时的工作,但用户单次最长只敢让它跑42分钟。技术能力与实际应用之间存在巨大的“部署积压”缺口。
03
Token需求“通胀”
算力正在经历价值重估
智能体应用的爆发背后,是整个行业正在经历的算力变局。
高盛近期发布的一份报告指出,Token需求正进入“通胀”周期。这个听起来有些古怪的说法,正在成为华尔街的新共识。
各大投行的预测数据惊人地一致:
如果说这些数字过于抽象,可以换个角度看:到2027年,全球AI每天消耗的Token量,将超过2024年全年。
Token需求为何会如此急剧增长?业内普遍认为有三个核心驱动力:
第一,技术迭代。从单次问答到多轮对话,从对话到智能体自主执行,每次技术跃迁都带来算力消耗的指数级增长。自主执行只是开始。
第二,场景扩容。火山引擎最新发布的Seedance 2.0模型定价显示,纯生视频每百万Token收费46元,一段15秒的视频需消耗30.888万Token,成本约15元。视频生成等高消耗场景正在成为主流。
第三,商业落地。阿里云的Coding Plan因订阅量激增不得不调整优惠策略。企业级AI应用正在从“试水”走向“规模化”,Token消耗随之水涨船高。
开源证券预测,2026年国内AI算力企业的平均毛利率将从28%升至35%。算力价格的上行压力,正在从基础设施层传导至应用层。
04
谁在为“永动AI”买单?
开发者生态的两难选择
在AI智能体的开发者社区里,一场关于“成本伦理”的讨论正在发酵。
支持者认为,这是技术创新的必经阶段。“早期汽车比马车贵多了,汽油也不是一般人买得起的。基础设施完善了,成本自然会降下来。”
反对者则指出,问题不在于贵,而在于“不可预期”。“我知道它贵,但我不知道它什么时候会突然更贵。这种不确定性才是最致命的。”
一位开源贡献者在讨论帖中写道:“我们正在创造一个需要‘算力石油’的物种,但还没有人教会它省着点跑。”
目前,开发者的应对策略五花八门。有人在代码里加了“预算阀门”,一旦Token消耗超过设定阈值就自动暂停;有人采用“夜跑模式”,只在夜间用电低谷时让智能体执行任务;还有人干脆放弃国际模型,全面转向国产API。
MiniMax M2.5的百万Token输出成本仅为Claude的1/6,成为许多开发者的替代选择。但即便如此,重度用户日均消耗仍在千元级别。对个人开发者而言,这仍是不小的负担。
05
智能体的未来
成本透明化是必答题
AI智能体的爆火,无疑把智能体商业化的一道深水区问题推到了聚光灯下:当AI从“偶尔用”变成“永远在线”,成本结构将如何重塑?
这个问题没有标准答案。但业界的共识正在形成:成本透明化是智能体走向规模化的必答题。
一位AI创业者这样描述他的焦虑:“我可以接受它贵,但我需要知道它贵在哪里;我可以接受它偶尔跑偏,但我需要知道它为什么跑偏。现在的智能体像一个黑盒,输出是透明的,但成本和过程不透明。”
Gartner近期发布的《数据可观测性工具市场指南》揭示了一个有趣的现象:53% 的数据+AI领导者已采用数据可观测性工具,另有43% 计划在18个月内采用。AI工作负载正是这一趋势的首要驱动因素。
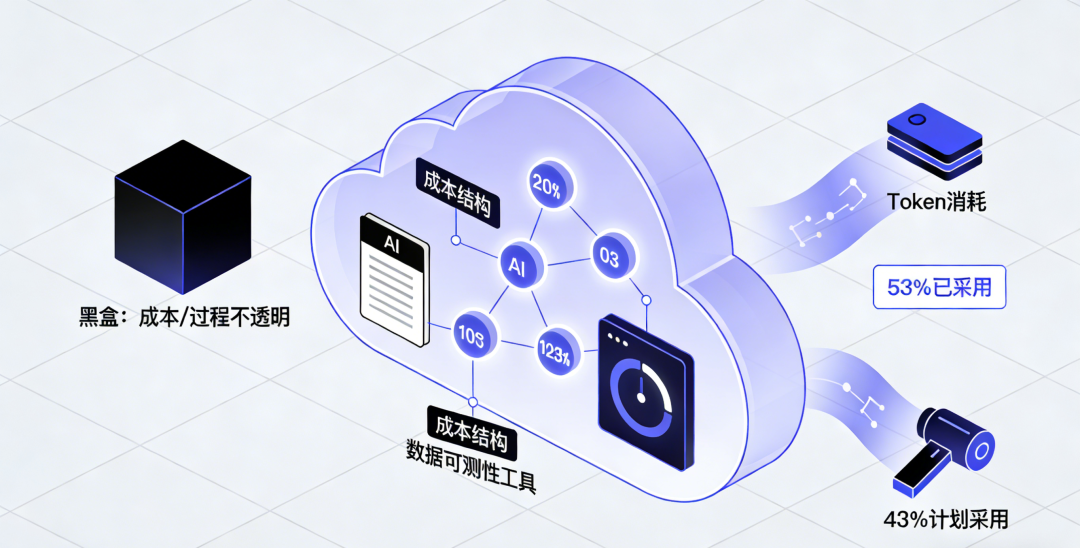
在Agentic AI场景中,坏数据不仅产生错误报告,还可能触发自主智能体采取错误行动。而成本失控,某种程度上也是一种“坏数据”:缺乏对Token消耗模式的实时感知,导致决策失误。
从这个角度看,智能体引发的“成本焦虑”,实际上是整个行业走向成熟必经的阵痛。当所有人都习惯了“点一次收一次费”的消费模式,突然面对一个“永远在跑、永远在花钱”的新物种,认知的错位在所难免。
本文由TalkingData数据研究中心出品。我们持续跟踪AI数据领域的前沿动态,定期发布深度报告与行业洞察。
如需转载或获取更多内容,请联系:TD_Marketing@tendcloud.com
关注TalkingData,获取更多数据洞察与行业分析。
END
高质量数据集是未来AI 发展的支撐。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享