想象一下:你买了一辆续航300公里的电动车,却只敢在小区门口转悠,生怕开到半路没电——这就是今天企业与AI智能体的真实关系。
2026年2月,Anthropic发布了一份特殊的“行为实测报告”。它没有炫耀Claude的算力有多强,反而揭开了智能体商业化进程中最尴尬的一道伤疤:技术已经能跑马拉松,但人类只敢让它跑短跑。
Anthropic最新实测报告曝光一组矛盾数据:
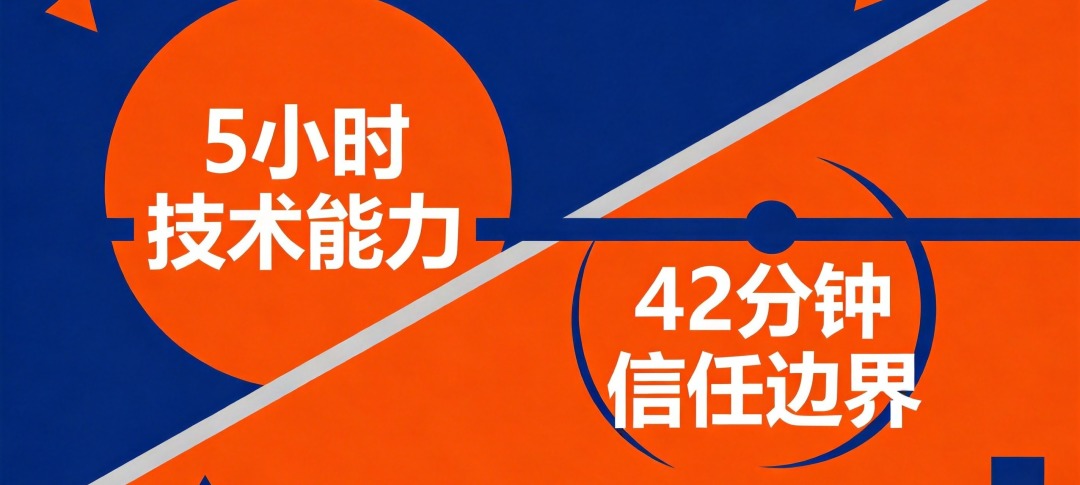
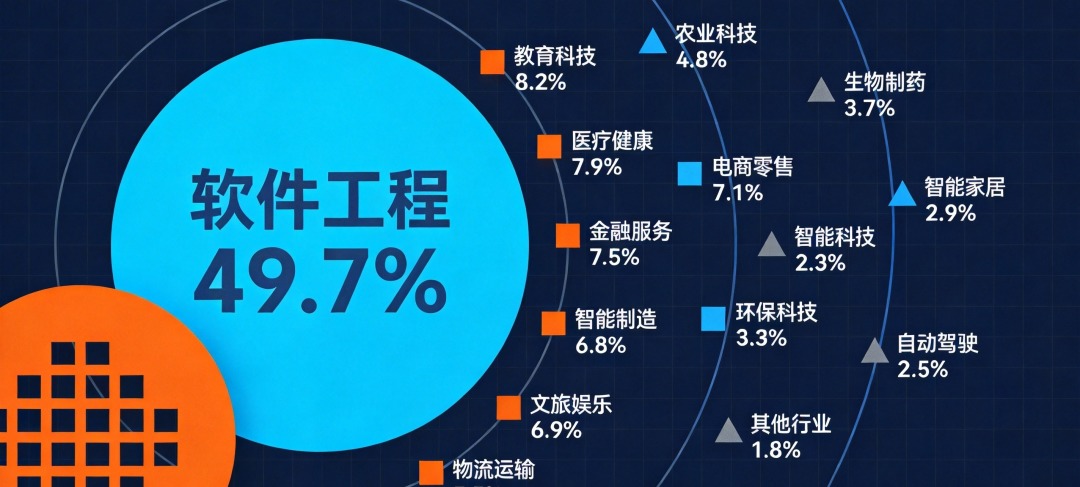
Claude已能独立完成近5小时的复杂工作,但用户单次最长只敢让它跑42分钟。软件工程独占49.7%的智能体工具调用量,其他16个垂直行业(包括医疗、金融、法律、教育等)合计不足50%,单一行业均低于9%。
技术能力与实际应用之间,横亘着一道巨大的“信任鸿沟”。
这背后指向一个核心判断:数据的流通成本与人类信任的建立速度,已经落后于算法的进化速度。
“
PART ONE
数据的AB面:
5小时能力 vs 42分钟“安全线”
报告中这组对比数据,像一把手术刀,切开了智能体时代的真实图景。
B面却给行业泼了一盆冷水:从2025年10月到2026年1月,即使AI能力持续迭代,最头部的那批用户(第99.9百分位),其单次会话时长也只从不足25分钟爬升到42分钟。
A面令人振奋:Claude已经能够自主规划任务、调用各类工具,独立完成原本需要人类投入近5小时的工作流。这意味着在理想状态下,AI可以像一个“数字员工”一样,连续处理复杂任务而不需要人类插手。
技术能力增长了,但信任的增长慢得多。
TalkingData洞察
这组数据揭示了一个核心矛盾:“能力盈余”与“信任赤字”。技术已经跑到了时间的前面,但用户的“信任预算”严重不足。在数据层面,这表现为巨大的“部署积压”:前沿模型的真实调用率,远低于其技术上限。
对于普通企业来说,这就像花重金请了一位顶级专家,却只敢让他干点助理的活,不是他能力不够,是你还没学会相信他。
“
PART TWO
16个行业不足9%:
智能体的“空白地图”
报告中最具冲击力的,是智能体工具调用量的行业分布。
软件工程独占49.7%,接近一半。而其他16个垂直行业(包括医疗、法律、金融、教育等)每个行业的调用量都不足9%。
这清晰地告诉我们:AI智能体目前仍是一个高度“圈地自萌”的工具,主要服务于自己的创造者——程序员。
为什么其他行业出现了大片的“数据荒漠”?不是因为技术不具备普适性,而是因为数据流通的成本与反馈周期不同。
第一重壁垒:数据孤岛 vs 数据流通
软件工程的工作流完全在数字环境中,代码、文档、API都可被AI直接“吞入”处理。程序员每天面对的就是屏幕,AI只需要“看懂屏幕”就能帮忙。
而在医疗或金融行业,核心数据被锁在复杂的合规系统里、锁在纸质病历里、锁在监管的保险柜里。AI连“看”都看不到,何谈调用工具?
第二重壁垒:效果反馈的滞后性
代码写错了,编译器会立刻报错——这种即时反馈让人类敢于试错。但法律文书是否严谨?金融风控是否合规?医疗诊断是否准确?这些需要漫长的验证周期,有的甚至要等几个月才知道结果。
人类对无法即时反馈的事物,天生缺乏信任感。
硅谷顶级孵化器Y Combinator CEO陈嘉兴评论:“那片几乎空白的区域,藏着下一代300个独角兽。”
TalkingData洞察
这300个独角兽的诞生,不仅需要算法进步,更需要一场“数据基础设施”的打通运动,把垂直行业的核心业务流程数据化、标准化、可被AI读取。同时,还需要针对不同行业的反馈周期,设计差异化的“信任机制”
“
PART THREE
老手与新手:
信任的两副面孔
人类对AI的信任并非一成不变。Anthropic通过对比用户行为数据,描绘出一条清晰的信任进化路径。
当用户累计使用AI超过750次,成为“老手”后,其行为出现了看似矛盾的分化:
更敢于放手:“全自动批准”模式的启用率从约20%飙升至40%以上。
更敢于叫停:他们主动打断AI自主运行的频率也翻倍了,从5%上升到9%。
这组数据乍看矛盾,细想却极其合理。
新手用户的信任是基于“感觉”:要么全信(导致翻车后彻底不信),要么不信(导致直接弃用)。
而老手用户的信任是基于“数据建模”:他们在心里已经给AI画出了一张“能力边界图”,知道哪些事可以闭眼交给AI,哪些事一旦出现苗头就必须介入。
信任不是盲从,而是“我知道你能做什么,也知道你不能做什么”。
报告还揭示了一个耐人寻味的细节:Claude主动暂停向用户确认的次数,是用户主动打断的两倍多。这意味着,在当前阶段,模型对自身能力边界的不确定性评估,比人类用户的担忧更为保守。
TalkingData洞察
这组数据完美诠释了什么是“理性的信任”。给所有智能体服务商的启示:提升用户粘性的关键,不是让AI永不犯错,而是帮助用户快速建立这张“能力边界图”。谁能提供更透明的过程反馈、更清晰的置信度提示,谁就能更快赢得信任。
“
PART FOUR
成本黑盒:
压垮信任的最后一根稻草
为什么普通用户不敢让AI跑满5小时?除了对“任务完成度”的担忧,还有一个更现实的恐惧:成本失控。
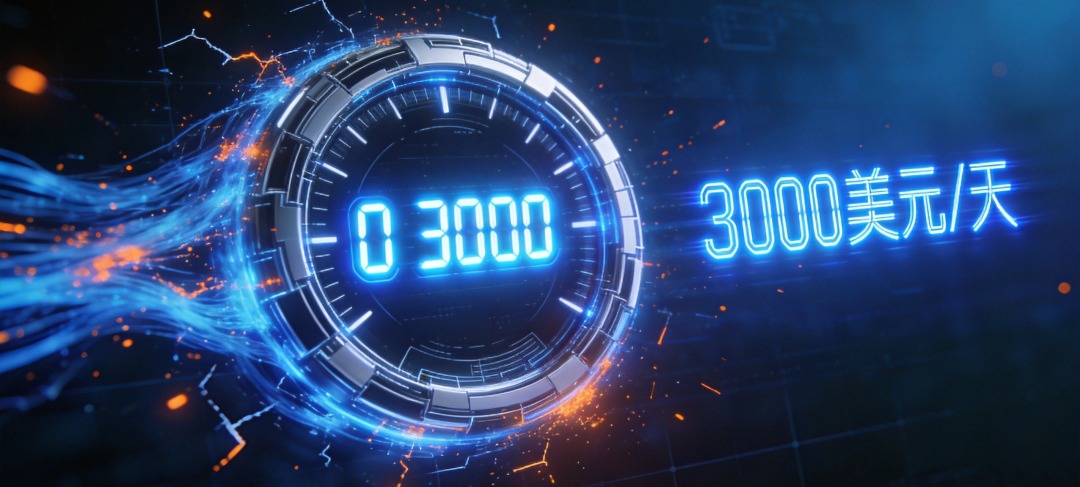
方正证券的研报曾指出,算力成本失控是企业级应用的核心顾虑。报告中提到的OpenClaw重度用户案例极具代表性:日均消耗3000万至1亿Token。
按现行市场价格估算,这意味着单日最高成本可能高达3000美元。
一位受访企业CTO的吐槽在圈内广为流传:“我不是不相信它的能力,我是不相信它的账单。万一它跑偏了,一个晚上烧掉我一个月预算怎么办?”
对于企业决策者来说,这不是在雇佣一个员工(员工工资是固定的),而是在签一张“空白支票”。
TalkingData洞察
我们将这种现象称为“成本黑盒效应”。当AI的运行成本像出租车计价器一样不停跳字,且无法预知终点时,乘客的唯一本能就是“随时准备下车”,这就是为什么用户宁愿频繁打断,也不敢让模型自主运行太久。不是不信任能力,是不信任账单。
因此,下一阶段智能体竞争的关键,可能不仅是比拼谁的模型更聪明,更是比拼谁能为用户提供“成本可视化”和“预算封顶”的能力。只有当成本变得可预期,信任才能真正沉淀下来。
“
PART FIVE
给行业的三个启发:
如何跨越信任鸿沟?
基于上述数据与洞察,可以梳理出三点启发,供行业参考:
1. 设计“信任刻度尺”
在智能体交互界面中,不仅展示“它在做什么”,更要展示“它有多确定”。类似自动驾驶的置信度显示,让用户随时感知AI的状态,逐步建立边界感。
2. 行业定制化反馈周期
对于医疗、金融、法律等长反馈周期行业,初期应设计更多“人工确认节点”。把流程拆碎,每完成一个小环节就让用户确认一次,用高频微交互积累信任,再逐步放宽权限。
3. 成本透明化是信任基石
提供Token消耗的实时预估与预算预警功能,把“成本黑盒”变成“成本仪表盘”。就像网约车的预估价功能,用户心里有底,就敢下单。
【下期预告】: 趋势预言家:看Token需求“通胀”如何重塑算力价值。
关注TalkingData,获取更多数据洞察与行业分析。
END
高质量数据集是未来AI 发展的支撐。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享