过去两周,我们陆续讨论了AI的“成本黑盒”“信任鸿沟”“Token通胀”和“数据可观测性”。这些技术问题和经济问题,看似各自独立,实则指向同一个方向——AI需要高质量数据。
如今,政策给出了答案。
2026年2月,国家数据局等四部门联合发文,首次明确“支持数据商开发高质量数据集”“面向人工智能发展,加快高质量数据集建设”。这是国家层面首次将高质量数据集与AI发展直接挂钩。
一个多月后,3月23日中国发展高层论坛上,国家数据局局长刘烈宏披露了最新数据:我国日均Token调用量已突破140万亿,两年增长超1000倍;已建成高质量数据集超过10万个,总体量超890PB。
政策的出手,恰逢产业爆发的拐点。
当成本焦虑、信任缺口、Token通胀、数据可观测性成为行业热点,政策给出了最终方向:AI数据,不是边缘业务,而是核心基础设施。
PART 1
被忽略的那段话
2026年2月3日,国家数据局等四部门联合发布《关于培育数据流通服务机构 加快推进数据要素市场化价值化的意见》。在数据要素圈内,这份文件被称作“数据流通服务机构的身份证”。
但很多人忽略了其中的一段话:
“支持数据商加大数据产品和服务开发力度,探索高质量数据集、数据模型、数据指数、数据即服务等新模式……面向人工智能发展,加快高质量数据集建设,为模型训练推理提供可靠数据支撑。”
这是国家层面首次将“高质量数据集”与“人工智能发展”直接挂钩。
就在政策发布一个多月后,3月23日中国发展高层论坛上,国家数据局局长刘烈宏披露了最新数据:我国日均Token调用量已突破140万亿,两年增长超1000倍;已建成高质量数据集超过10万个,总体量超890PB。
政策出手的时机,恰逢产业爆发的拐点。
当AI开发者们在为Token消耗焦虑,当Anthropic的报告揭示人机信任的缺口,当高盛预言Token需求通胀,当Gartner提出数据可观测性——所有这些技术问题和经济问题,最终都指向同一个方向:AI需要高质量数据,而政策正在为此铺路。
TalkingData洞察
这份文件最值得关注的,不是它说了什么,而是它把“高质量数据集”和“人工智能发展”放在同一句话里。这意味着国家层面对AI产业的认知已经升级:AI的核心竞争力,不再只是算力和算法,数据质量正在成为决定AI成败的关键变量。过去我们说“算力是AI的发动机”,现在政策告诉我们:高质量数据,才是发动机的燃料。
PART 2
为什么政策在这个时间点强调AI数据?
政策的出台不是偶然。它回应了行业正在发生的三大变化:
第一,成本失控倒逼数据质量需求
ONE
OpenClaw的案例证明,智能体的“永动模式”正在引爆算力成本。但高成本背后,是低质量数据导致的无效计算。
如果训练数据质量足够高,模型可以少犯错、少重复、少消耗。高质量数据,是控制Token成本的源头。
第二,信任缺口需要数据可观测性
TWO
Anthropic的报告显示,人类只敢让AI跑42分钟,根本原因是对AI决策过程的不信任。而数据可观测性,正是打开“黑匣子”的钥匙。
政策鼓励“高质量数据集建设”,为数据可观测性提供了制度支撑——当数据来源清晰、质量可追溯,AI的决策才有了可信的依据。
第三,Token通胀重塑算力价值
THREE
高盛的预测揭示了一个事实:Token正在成为硬通货。当算力不再是免费午餐,高质量数据就成了“省着用”的关键。同样的Token消耗,高质量数据带来更高价值;同样的算力投入,高质量数据产生更好效果。
TalkingData洞察
这三个变化看似独立,实则指向同一个本质:AI产业正在从“粗放式增长”转向“精细化运营”。过去大家比谁的算力大、谁的参数多,现在比谁的数据质量高、谁的成本控制好。政策在这个时间点出手,不是偶然,而是产业演进到了需要“标准”和“方向”的阶段。
PART 3
政策为AI数据行业解决了什么问题?
过去,数据标注、数据集建设常被视为“劳动密集型产业”,价值被低估。政策明确将数据商定位为“产品供给与专业服务的提供者”,并专门强调“面向人工智能发展”的数据集建设。这不是边缘业务,是战略方向。
政策鼓励“高质量数据集”“数据模型”“数据即服务”等新模式。这些正是AI数据行业的核心方向。企业可以放心投入,不用担心政策风险。
数据流通最大的障碍是“不敢共享”。政策明确了数据商的合法地位,为数据流通提供了制度框架。字节合作、可信数据空间等实践,有了政策依据。
TalkingData洞察
政策解决的三个问题:身份、方向、合规,这恰好是AI数据行业从“野蛮生长”走向“成熟市场”必须跨越的三道门槛。身份认同解决了“我是谁”的问题,方向指引解决了“往哪走”的问题,合规保障解决了“能不能走”的问题。当这三道门槛被政策一一拆除,行业才能真正起飞。
PART 4
从政策看未来:AI数据的三大趋势
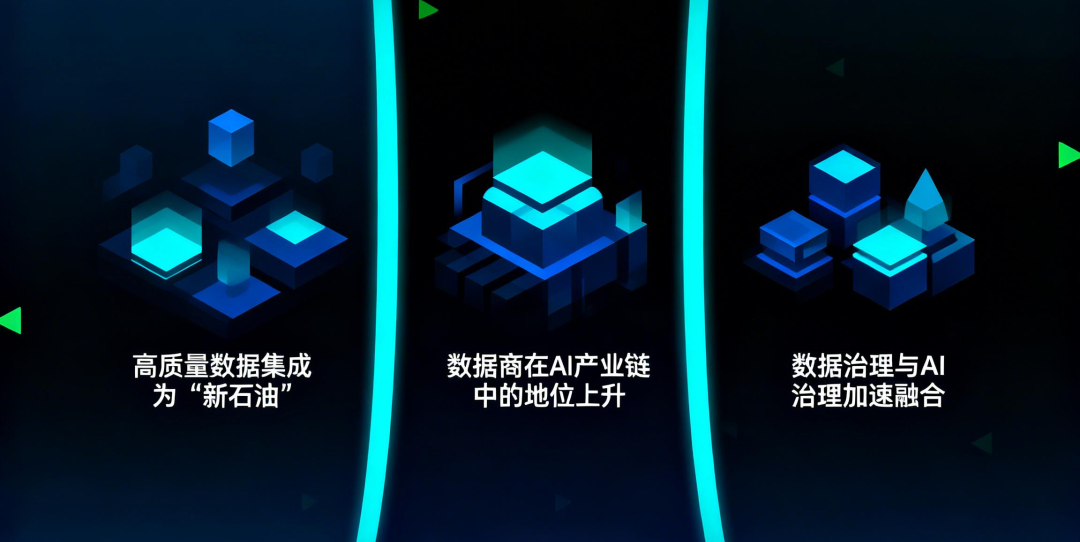
高质量数据集成为“新石油”
政策多次强调“高质量数据集”,并将其与AI发展直接挂钩。可以预见,未来三年,各垂直领域的高质量数据集将成为最稀缺的资源。医疗、金融、法律、教育——谁掌握了行业数据,谁就掌握了行业AI的主动权。
数据商在AI产业链中的地位上升
政策将数据商与数据交易所、数据流通服务平台并列为三类核心机构。数据商不再是“做数据的”,而是“做AI基础设施的”。这个身份转变,将带来估值逻辑的重塑。
数据治理与AI治理加速融合
政策强调“为模型训练推理提供可靠数据支撑”。这意味着,数据治理不再是后台工作,而是AI质量的前置条件。数据可观测性、数据质量、数据合规,将融入AI开发的全流程。
TalkingData洞察
这三个趋势指向同一个结论:数据正在从“成本中心”变成“价值中心”。过去企业做数据治理是为了“不出错”,未来做数据治理是为了“更值钱”。谁能率先在垂直领域构建高质量数据集,谁就能在AI时代占据不可替代的生态位。这不是技术问题,而是战略问题。
PART 5
TalkingData视角:
AI数据的全链路闭环
回顾这五篇文章,从OpenClaw的成本黑盒,到Anthropic的信任鸿沟,到高盛的Token通胀,到Gartner的数据可观测性,再到国家政策的方向指引。我们拼出了AI数据时代的完整图景:问题已经显现,共识正在形成,政策已经出手,工具正在成熟。
而贯穿这一图景的,是一条完整的AI数据价值链:
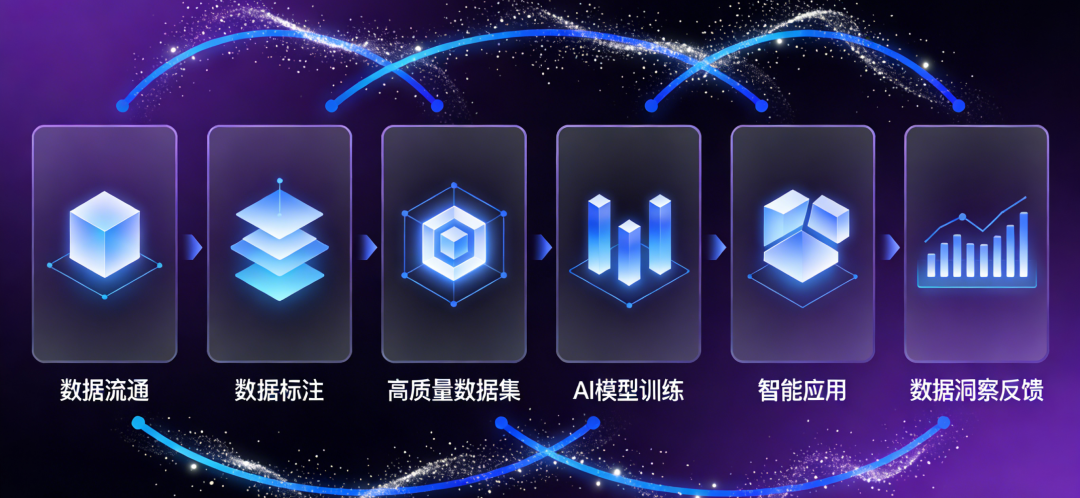
这正是TalkingData的核心能力闭环:
数据流通:TalkingData是国家试点的流通流通基础设施,深度参与数据要素市场建设,推动数据合规流通,为AI应用提供“活水源头”
数据标注:拥有专业的数据治理与标注能力,将原始数据转化为模型可理解的结构化信息
高质量数据集:为各行业构建AI应用供给高质量数据,是AI模型的“燃料库”,覆盖非结构化、多模态、高知识密度及AI合成数据等全类型高质量数据集
AI模型训练:将高质量数据注入模型训练,让AI真正“懂行业、懂业务”
智能应用:赋能企业构建智能营销、智能风控、智能运营等场景应用;构建国内领先的大模型聚合平台,不断探索AI内容制作、广告素材创意等智能体应用
数据洞察反馈:通过数据可观测性能力,实时监测数据质量、追踪模型效果,形成“用数据优化数据”的闭环
这个闭环的价值在于:数据不只是AI的输入,更是AI的输出。 每一次智能应用的运行,都会产生新的数据洞察,这些洞察又反过来优化数据质量和模型效果——形成自我强化的正向循环。
当政策将“高质量数据集”定位为AI时代的战略资源,TalkingData已经在这场变革中占据了独特的位置。我们不只是数据的“搬运工”,更是AI数据全链路闭环的建设者。
数据来源:
国家数据局等四部门《关于培育数据流通服务机构 加快推进数据要素市场化价值化的意见》,2026年2月
中国信息通信研究院相关研究报告
本文由TalkingData数据研究中心出品。我们持续跟踪AI数据领域的前沿动态,定期发布深度报告与行业洞察。
如需转载或获取更多内容,请联系:TD_Marketing@tendcloud.com
TalkingData
写在系列最后
从3月19日到今天,我们用五篇文章,从五个视角拼出了AI数据时代的完整图景:
第一章 成本解剖师:OpenClaw的账单告诉我们,智能体时代的成本失控已经发生
第二章 行为观察员:Anthropic的数据告诉我们,信任缺口比技术缺口更大
第三章 趋势预言家:高盛的预测告诉我们,Token通胀正在重塑算力价值
第四章 概念翻译官:Gartner的洞察告诉我们,数据可观测性是应对之道
第五章 政策解读者:国家的新政告诉我们,高质量数据集已是战略方向
五篇文章,一个脉络,从成本黑盒到政策落地,这是产业演进的必然路径。
但这只是开始。如果说第一季回答的是“问题是什么”,那么第二季将回答“怎么办”。从战略到落地,从质量到合规,从度量到生态——我们将继续深入AI数据的最前线,为从业者提供可落地的思考。
AI数据观察系列 · 第二季
正在路上…
敬请期待
看AI数据,就找TalkingData。
关注TalkingData,获取更多数据洞察与行业分析。
END
高质量数据集是未来AI 发展的支撐。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享