数据开放月启动、32城数据标注扩围、首个工业互联网数据要素登记国标发布——数据要素政策正在从“顶层设计”密集走向“落地执行”。
近期,数据要素领域多项政策举措集中落地。从国家数据局指导的“数据开放月”,到32个城市启动第二批数据标注先行先试,再到首个工业互联网数据要素登记国家标准正式发布,政策信号密集,指向明确。
01
数据开放月:
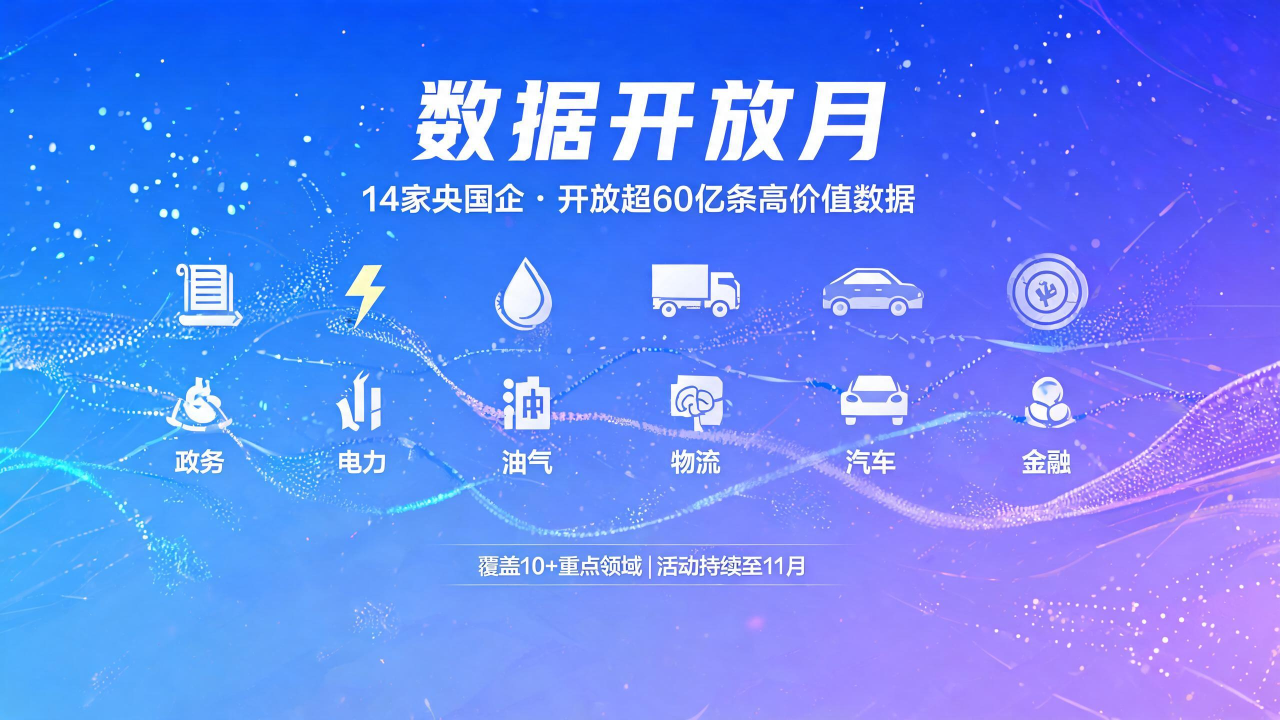
14家央国企开放超60亿条数据
在2026中国国际大数据产业博览会上,由国家数据局数据资源司指导,“数据开放月”活动正式启动。活动由南方能源行业可信数据空间联合可信数据空间发展联盟、国家人工智能中试基地(能源领域电力方向)及13家央国企共同发起。
首批14家央国企面向全社会免费开放高价值数据资源,累计开放540余项高质量数据资源,总量突破60亿条,覆盖政务、电力、油气、物流、汽车、金融等10余个重点领域。活动将持续至11月。
长期以来,大量高价值数据沉睡在少数机构手中,无法进入生产环节创造价值。此次“数据开放月”是央企国企在数据开放上规模较大的一次集体行动。国家数据局相关负责人表示,此举旨在推动数据供需精准对接和高效开发利用,促进数据价值释放。
TalkingData洞察
数据开放月的意义不在于“60亿条”这个数字本身,而在于它验证了一件事:高价值数据可以走出封闭系统,进入更广泛的流通环节。对数据服务行业而言,这释放了一个清晰的信号——数据供给正在从“个案授权”走向“制度化开放” 。当更多公共数据和行业数据进入流通市场,数据服务商的数据来源将更加丰富,但也意味着需要在数据质量、合规治理等方面建立更强的能力。
02
数据标注扩围:从7城到39城
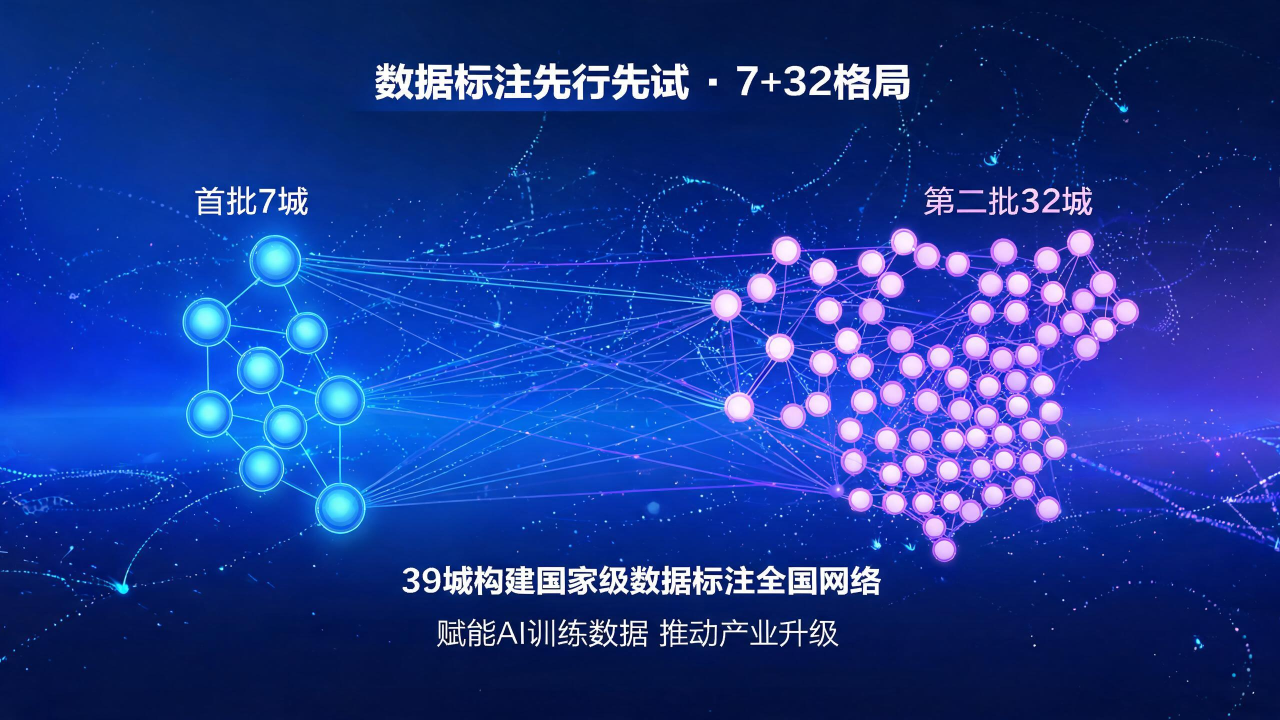
在2026数博会上,国家数据局宣布在32个城市启动第二批数据标注先行先试工作。此前,我国已在成都、合肥等7个城市布局数据标注先行先试。加上新一批32个城市,总共将有39个城市开展数据标注先行先试。
数据标注相当于给原始数据打标签,标注好的数据可用来训练人工智能。第二批试点涵盖工业制造、医疗健康、交通运输、具身智能等重点行业领域。国家数据局副局长夏冰表示,将把“7+32”打造成为国家级数据标注的全国性网络,推动数据标注产业从起步培育期迈向快速成长的新阶段。
TalkingData洞察
从7城到39城,数据标注产业的空间布局正在快速扩张。这背后是AI从通用走向垂直的现实需求——不同行业、不同场景对训练数据的需求差异巨大,需要专业化的数据标注能力来支撑。数据标注正在从“通用服务”走向“行业定制” ,能够在垂直场景中建立标注能力的服务商,将获得更大的市场空间。
03
首个工业互联网数据要素登记国标发布
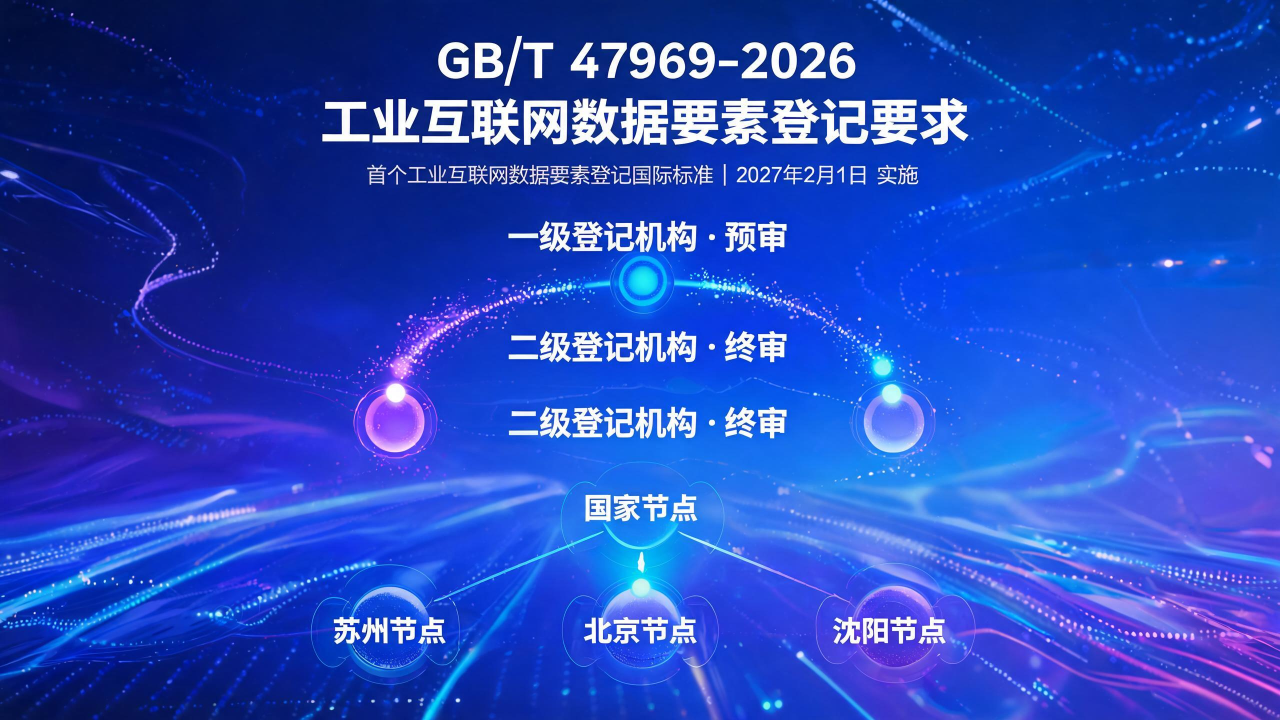
经国家市场监督管理总局(国家标准化管理委员会)批准,推荐性国家标准GB/T 47969-2026《工业互联网数据要素登记要求》正式发布。这是首个工业互联网领域数据要素登记国家标准。
标准由中国工业互联网研究院牵头起草,联合工业企业、平台企业、高校、科研院所及数据交易机构等40余家单位共同编制完成,将于2027年2月1日起正式实施。
标准针对工业数据存储分散、动态更新、商业敏感度高等特点,构建了一级登记机构预审与二级登记机构终审相结合的两级登记架构。目前,中国工业互联网研究院已牵头建设工业数据资产登记平台,形成“国家—城市”两级登记体系,已上线国家节点和苏州、北京、沈阳三个城市节点。
TalkingData洞察
工业互联网数据要素登记国标的发布,标志着工业数据的流通有了统一的规则。过去工业数据“不敢流、不愿流”,很大程度上是因为缺少标准化的登记和确权机制。标准的意义不在于“管”,而在于“通” ——当数据有了统一的登记规则和格式要求,跨企业、跨行业的流通才具备技术基础。对数据服务企业而言,这意味着工业领域的数据服务市场正在打开,但前提是自身的服务能力需要对齐国家标准。
04
数据产业规模已超6万亿元
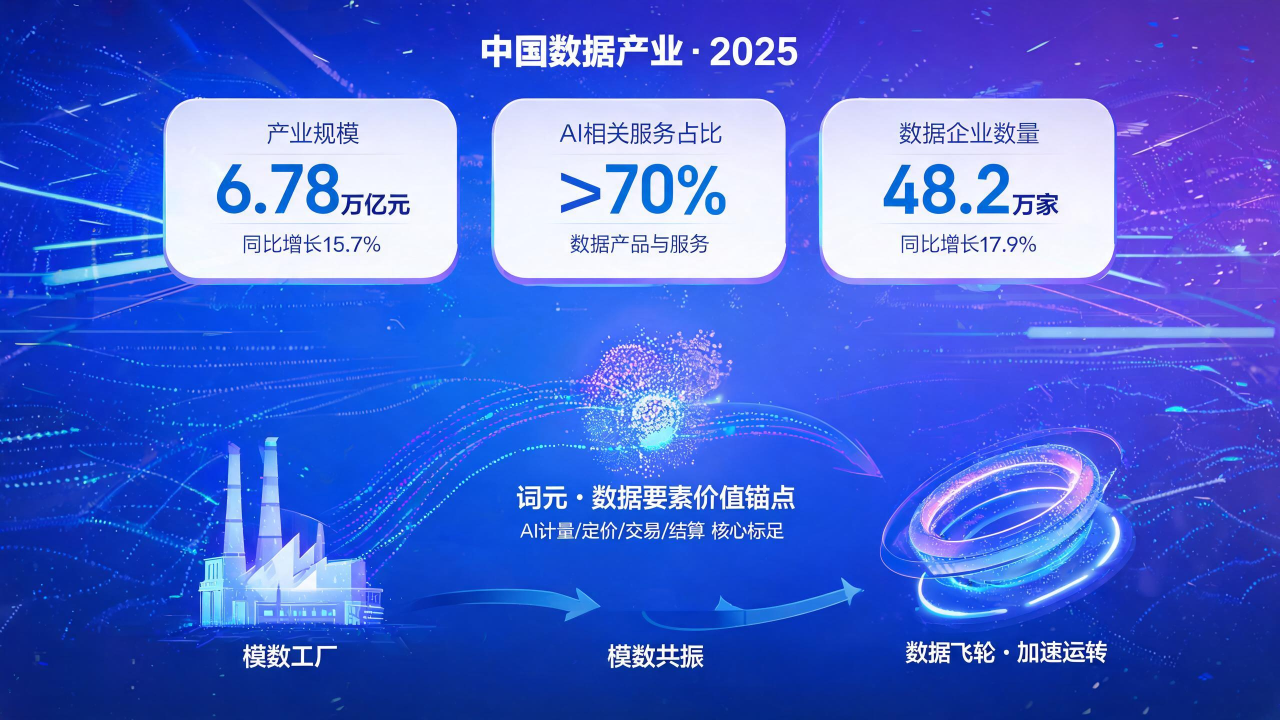
在2026数博会上发布的《中国数据产业发展报告(2026)》显示,我国数据产业规模已超6万亿元。2025年,我国数据产业规模为6.78万亿元,同比增长15.7%。和人工智能高度相关的数据产品与服务占到数据产业总产值的七成以上。截至2025年底,全国数据企业达48.2万家,同比增长17.9%。
与此同时,国家数据局局长刘烈宏近期在调研中明确提出,深入实施“人工智能+”行动,探索建设“模数工厂”,紧扣“词元——数据要素价值释放新路径”,以“模数共振”驱动“数据飞轮”加速运转。刘烈宏表示,词元作为数据要素价值释放的新路径,为人工智能服务的计量、定价、交易和结算提供重要的标尺,正成为智能经济时代重要的基础计量单位与价值锚点。
TalkingData洞察
6万亿产业规模、48万家企业——数据产业已经是一个不容忽视的经济板块。而“词元”被确立为数据要素价值释放的新路径,意味着数据价值的衡量标准正在从“有多大”转向“能产出多少有效词元” 。对数据服务企业而言,数据集的价值不再取决于体量大小,而取决于它能让模型产出多少高质量的Token。这正在从根本上改变数据产品的价值评估逻辑。
结语
数据开放月解决的是“数据出得来”的问题——通过央国企带头开放高价值数据,打破数据孤岛;数据标注扩围解决的是“数据用得上”的问题——为AI训练提供规模化、场景化的数据供给;工业数据要素登记国标解决的是“数据流得通”的问题——为工业数据流通建立统一的规则和标准。三件事指向同一个方向:数据要素正在从“政策概念”变成“可操作的产业实践” 。
对数据服务企业而言,这意味着数据采集、标注、治理、流通的全链条都将面临更明确的规则和更大的市场空间。
免责声明:
本文基于国家数据局公开发布的政策信息及公开报道撰写。文中分析观点为基于公开信息的独立判断,不代表任何官方立场。具体政策执行请以主管部门实际发布为准。
END
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撑。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享