这几天,AI领域同时释放了三个值得关注的信号:
信号一:GPT-5.5 Instant上线,高风险提示中幻觉声明减少52.5%。
信号二:中国AI大模型周调用量回升至7.942万亿Token,环比增长81.7%,再次超过美国。
信号三:中央网信办启动为期4个月的专项行动,重点整治大模型训练语料安全、AI数据投毒等问题。
AI变得更可靠了,用得更多了,规则的框架也更清晰了。三个信号看似各自独立,但指向一个共同的逻辑:数据,是这其中贯穿始终的关键变量。
No. 1
GPT-5.5 Instant上线:
专业场景更可靠
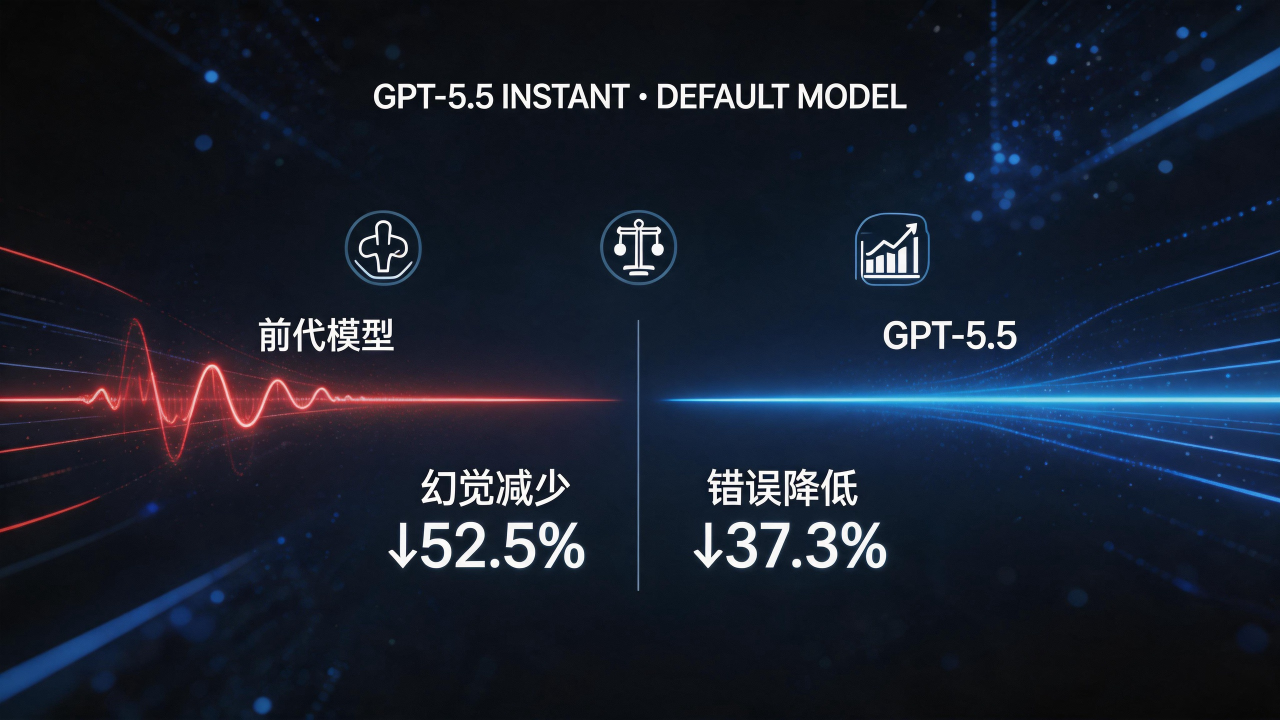
5月6日,OpenAI正式将GPT-5.5 Instant设为ChatGPT默认模型,免费与付费用户同步升级。
这次升级最受关注的不是参数量,而是专业场景的可靠性。内部评估显示,在医学、法律、金融等高敏感领域,GPT-5.5 Instant的幻觉声明比前代减少了52.5%。在用户此前标记存在事实错误的对话中,不准确声明降低37.3%。
技术与事实性方面的进步,为专业场景的AI应用提供了更有价值的参考方向。
TalkingData快评
模型更可靠,对训练数据的依赖也更清晰。降低幻觉率的背后,不是单纯的参数堆叠,而是训练阶段专业领域数据的深度覆盖与高质量标注。机器“更可信”的前提,是能从高质量数据中学习。
No. 2
调用量回升:
AI正在被规模使用
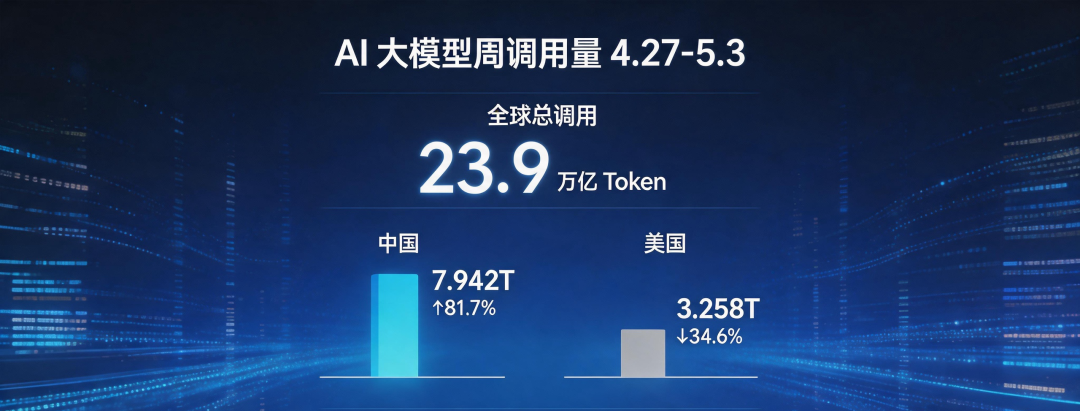
根据OpenRouter平台数据,上周(4月27日至5月3日),全球AI大模型总调用量为23.9万亿Token,连续两周上涨。
其中,中国AI大模型的周调用量上升至7.942万亿Token,环比增长81.7%,再次超过美国(3.258万亿Token,环比下滑34.6%)。
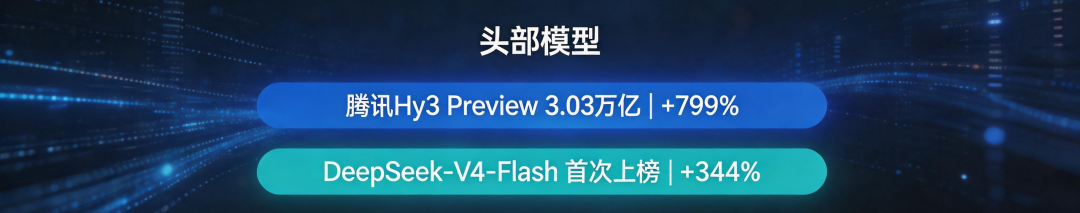
腾讯Hy3 preview(免费版)以3.03万亿Token位居榜首,环比大增799%。DeepSeek-V4-Flash首次上榜,环比增长344%。
调用量的数据变化,反映出AI应用正在从“功能体验”走向更大范围的规模化使用。
TalkingData快评
AI用得越多,对数据持续供给的质量和效率要求就越高。每一次调用产生的新数据,都可以用于模型的迭代优化。
工信部与国家数据局近期联合启动的“模数共振”行动,也正是从“数据-模型-场景应用”良性循环的角度,推动这一逻辑走向制度化。
No. 3
专项行动启动:
AI应用的治理框架更明确
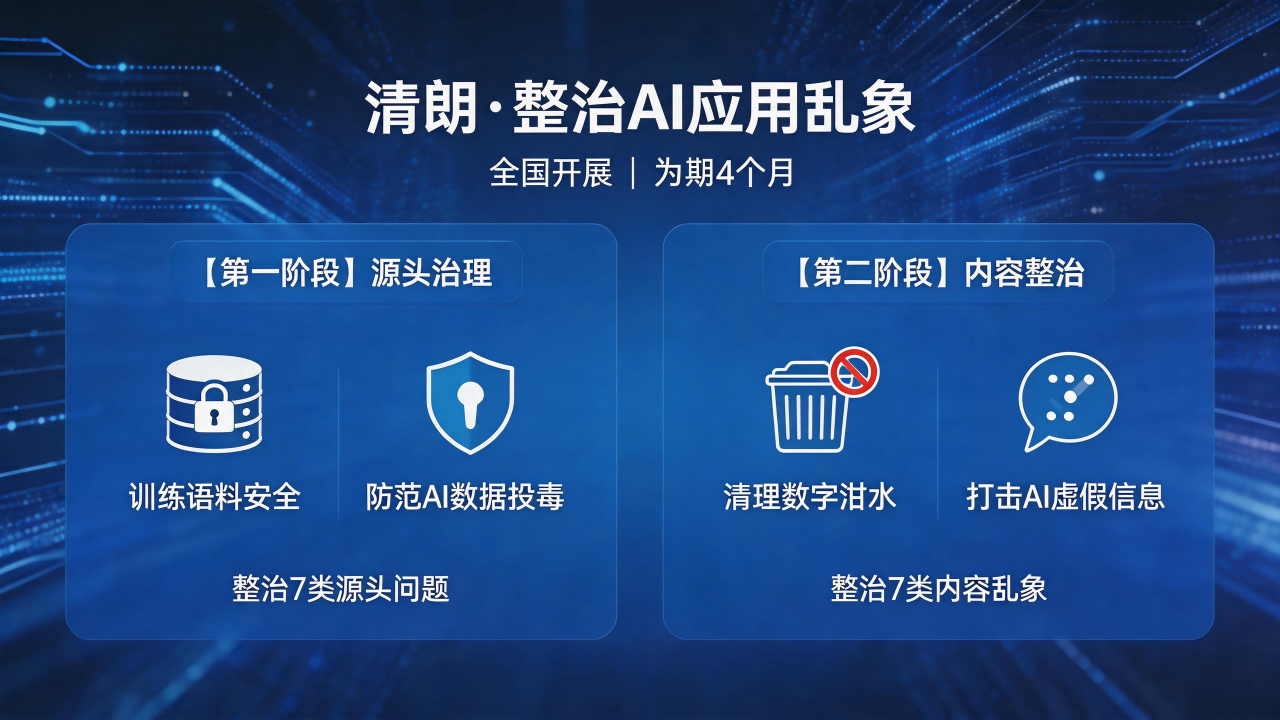
4月30日,中央网信办印发通知,在全国范围内部署开展为期4个月的“清朗·整治AI应用乱象”专项行动。
第一阶段聚焦AI应用服务的源头治理,重点整治未按规定履行大模型备案登记义务、安全审核能力不足、大模型训练语料安全、AI数据投毒、生成合成内容标识落实不到位等7类突出问题。
第二阶段聚焦利用AI技术生成“数字泔水”、制作发布虚假信息等7类内容乱象。
“大模型训练语料安全”和“AI数据投毒”被明确列入重点整治范围,反映出监管对数据源头治理的持续关注。
TalkingData快评
训练语料审核的标准和要求正在细化,数据来源合规、标注质量与安全防护正在成为AI应用的基础门槛。
数据不再是单纯的技术资源,而是产业准入和可持续运行的重要条件。
三件事,指向同一个方向
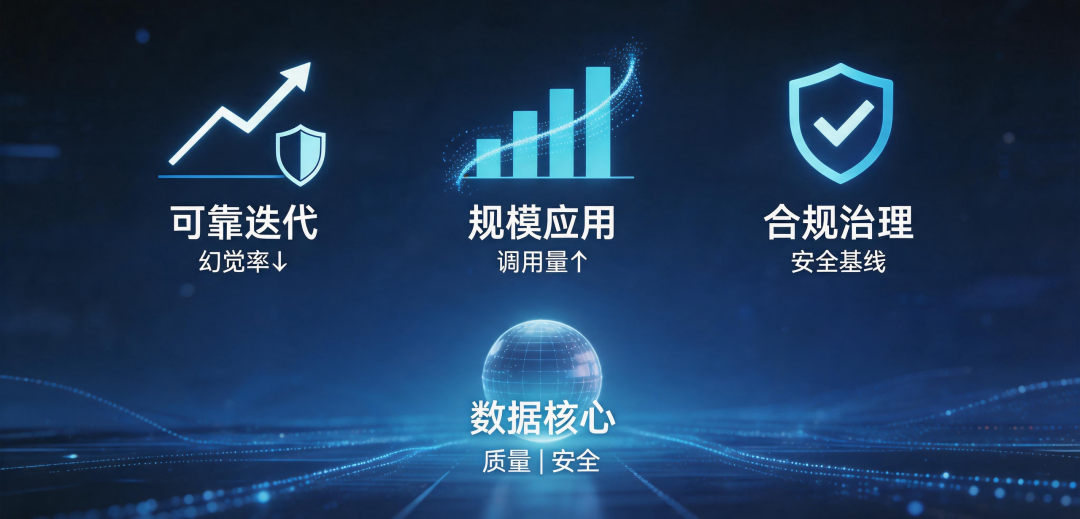
技术的迭代、应用的增长、规则的完善,这三件事共同指向一个方向:数据正在成为AI产业持续发展的核心要素之一。质量和安全,是其中的两个关键维度。
当AI加速融入更加具体的行业场景,数据的基础性作用也在被持续验证。让AI更可信、更可用、更规范,数据是贯穿全程的关键变量。
END
看AI数据,就找TalkingData。
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撐。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享