过去两周,OpenAI、字节、百度、DeepSeek、Anthropic、腾讯等先后释放模型更新。对比半年前的“百模大战”,行业竞争的关键词正在发生变化。
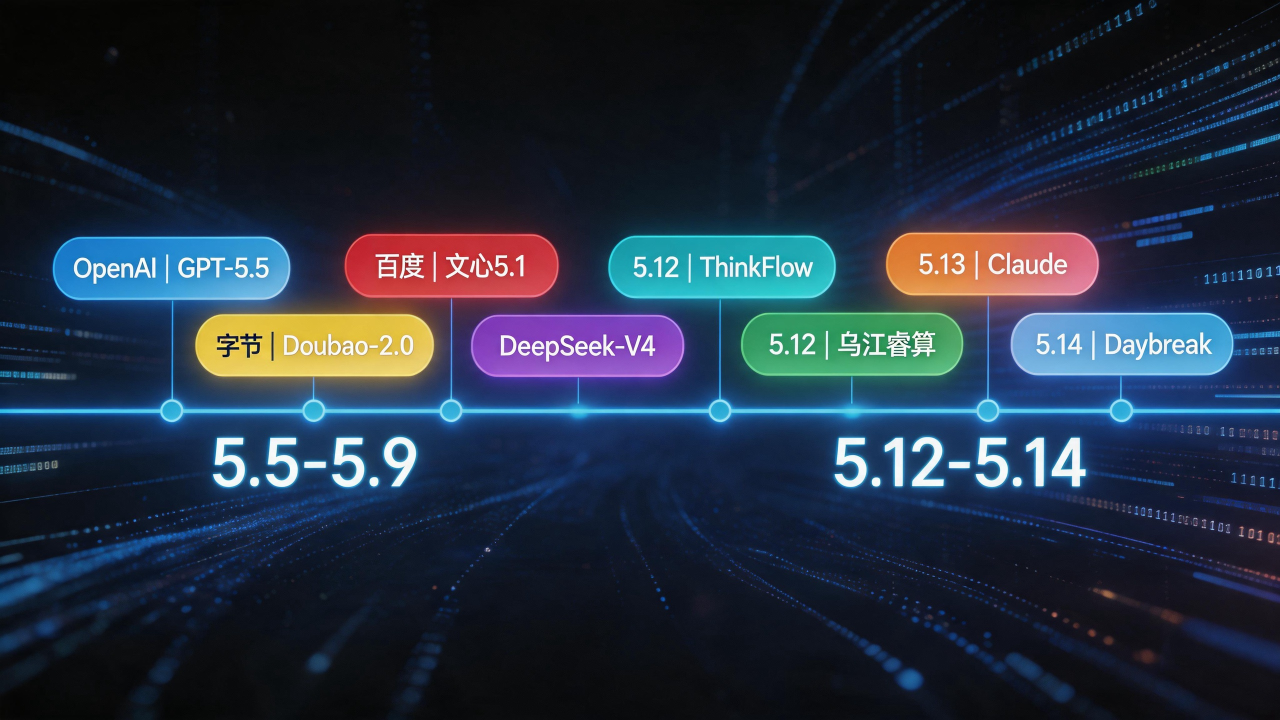
5月上旬至今,AI大模型领域经历了一轮密集的更新与发布。
5月5日至9日,OpenAI推出GPT-5.5 Instant并设为ChatGPT默认模型,字节跳动发布全模态理解模型Doubao-Seed-2.0-lite,百度推出文心大模型5.1,DeepSeek-V4系列持续发酵。
进入5月第二周,节奏并未放缓。
5月12日,网易有道发布企业级大模型聚合平台ThinkFlow;同日,华电乌江联合华为发布“乌江睿算”大模型,首次将AI大模型应用于江河径流预测。
5月13日,Anthropic举办“Code w/ Claude”开发者大会,发布Claude Platform代理编排能力和Claude Code桌面端;腾讯在财报电话会上宣布混元团队已开始研发更大参数量的下一代模型。
5月14日,OpenAI发布Daybreak安全AI计划,整合多个模型聚焦主动安全检测。
模型密集的发布背后,行业竞争的核心逻辑正在发生变化。
01
比谁更“省”:
成本降到6%,模型反而更好用了
过去一段时间最受关注的产品发布,大多不再以“参数量打破纪录”为核心卖点。
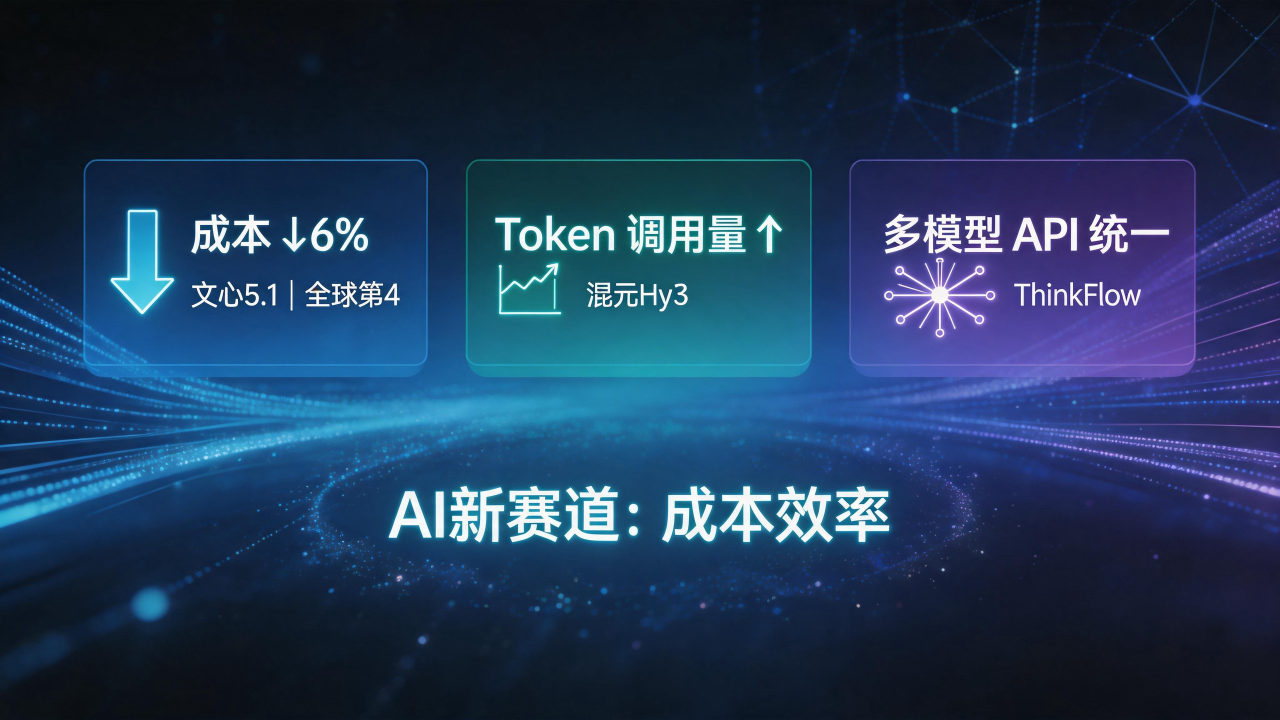
百度文心5.1将预训练成本压缩至业界同规模模型的约6%,总参数量和激活参数量均显著减少,但在LM Arena搜索榜上位列全球第四。
有数据显示,腾讯混元“Hy3preview”自4月底上线以来,在OpenRouter平台的Token消耗量已位居前列,内部Token调用量较前代版本有显著提升。
网易有道发布的ThinkFlow则选择不做新模型,而是通过标准API统一接入多款主流模型,提供智能路由与Token成本可视化功能。
这些案例显示,当模型基础能力逐步接近时,“如何用更低的成本达到相似的效果”正成为新的竞争焦点。
TalkingData洞察
从数据视角看,效率提升的源头之一是数据集质量的优化。更好的数据标注、更精准的数据筛选,能在不增加算力投入的前提下带来明显的模型表现提升。数据治理的质量,正在直接影响模型竞争的效率。
02
从“对话”到“协作”,交互方式正在重构
5月第二周的另一个趋势体现在交互方式的演进上。
Anthropic在开发者大会上重点展示了Claude Platform的代理编排能力,以及Claude Code桌面端在异步开发场景中的应用。这些功能让模型不再只是“回答问题”,而是能够参与代码编写、任务规划等更复杂的协作流程。
与此同时,苹果端侧AI框架oMLX发布0.3.9版本更新,在本地大模型的图文处理速度与易用性上有所提升。有行业分析认为,苹果在iOS 27中计划开放第三方AI模型接入选择权,也可能推动端侧交互体验的进一步演化。
交互方式从“单向问答”向“协同工作”演进,意味着AI不再只是信息提供者,而是开始成为任务参与者。
TalkingData洞察
交互方式的变化直接影响数据的生产与消费模式。协作过程中的操作日志、任务执行记录等新型数据量会快速增加,企业需要提前思考如何对这些数据进行有效采集与管理。
03
告别“万能模型”:懂行业的AI才是好AI
除了基础模型能力的更新,垂直场景大模型的落地也是近期值得关注的趋势。
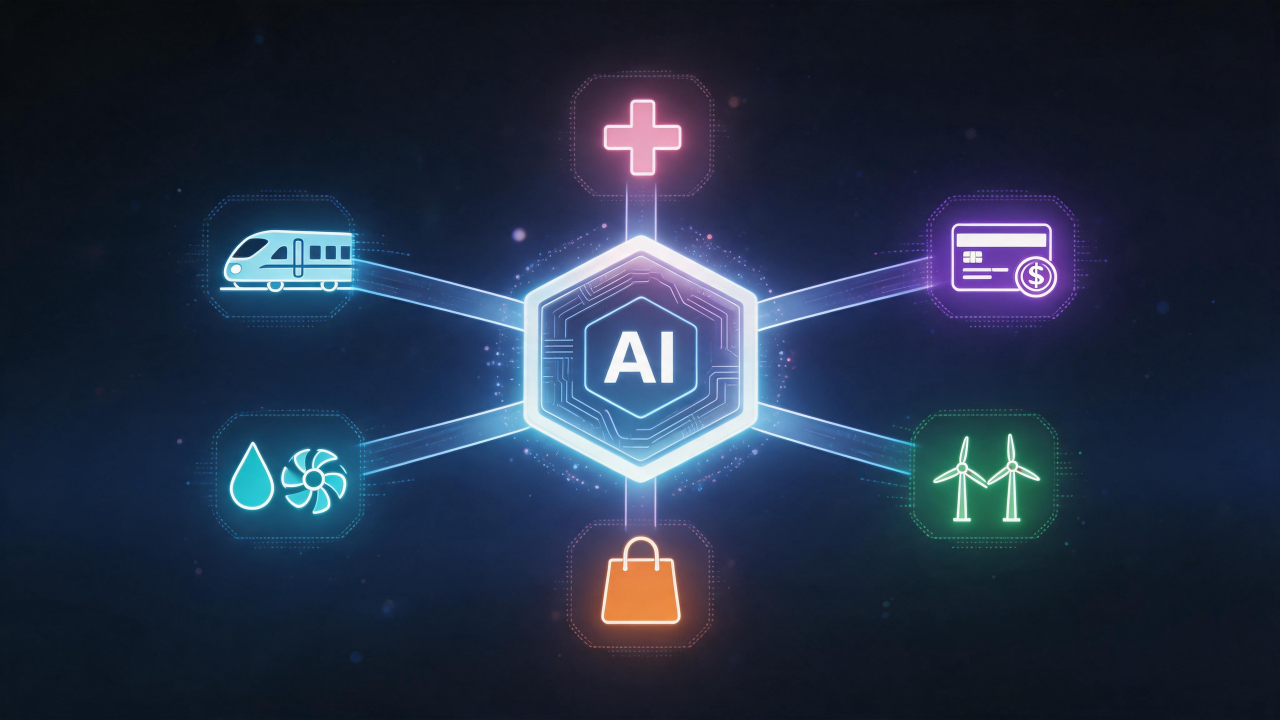
华电乌江联合华为发布的“乌江睿算”大模型,首次将AI大模型应用于江河径流预测,短期预测精度较传统机理模型有明显提升。项目已积累超50TB的高质量数据集,涵盖气象、径流、功率预测等多类场景。
高德5月14日发布交通智能体Traffic Claw,将智慧交通系统从“数据辅助”升级为“自主决策”,基于时空数据底座实现“对话即可获取分析结果”,替代过去跨系统调取数据、耗时数天的传统研判流程。
中天科技在5月16日发布了首期AI成果,以自研“天玑”工业大模型平台为核心,推出设备故障监测、数据湖仓驾驶舱等六大应用,并规划2026至2028年落地100项行业垂类模型。
这类行业大模型的特点在于:不追求通用能力的全面领先,而是聚焦特定业务场景,用高质量行业数据驱动模型发挥实际价值。水电、交通、能源等领域的实践表明,垂直场景可能是大模型短期内产生实际效益的重要方向。
TalkingData洞察
垂直场景大模型的落地成效,高度依赖行业数据集的积累质量。对于TalkingData而言,为各行业构建高质量数据集,覆盖非结构化、多模态、高知识密度等数据类型,正是支撑这一趋势的关键能力。
04
三个信号:
大模型的下半场比什么
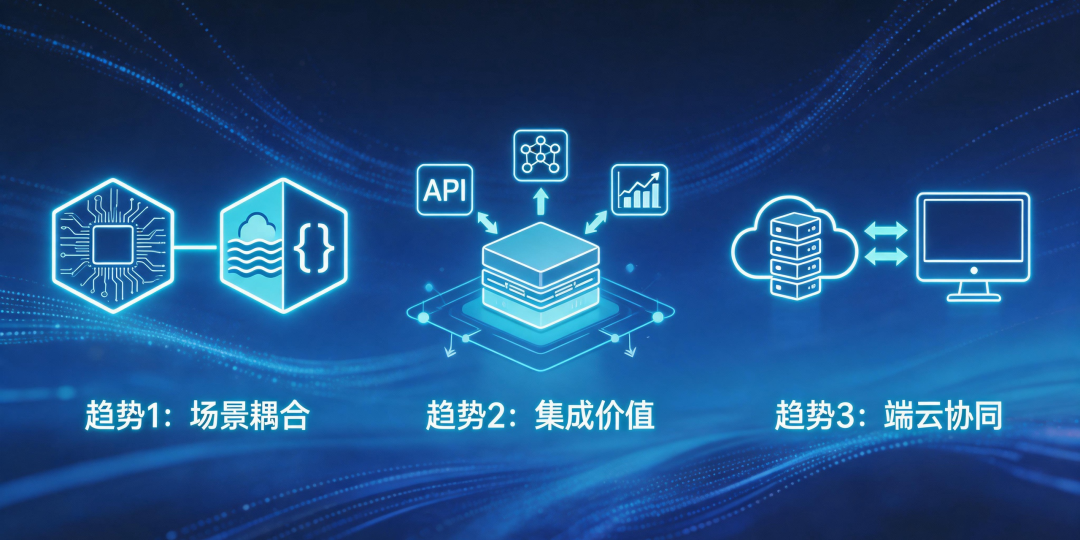
回顾过去两周的模型发布,可以总结出三个较为清晰的趋势信号:
TalkingData洞察
上述趋势共同指向一个判断:AI产业的竞争焦点正在从“模型有没有”转向“数据好不好、应用顺不顺、成本优不优”。
对于企业而言,构建一套覆盖数据流通、数据治理、效果评估的完整能力体系,与选择哪个具体模型同样重要。
一周之内,多家厂商密集发布模型更新——从底层模型迭代到场景大模型落地,从云端推理优化到端侧交互升级。
这些发布内容不同、赛道各异,但都在回应同一个命题:当基础模型能力逐渐趋于成熟,下一步的竞争力将从哪里来?
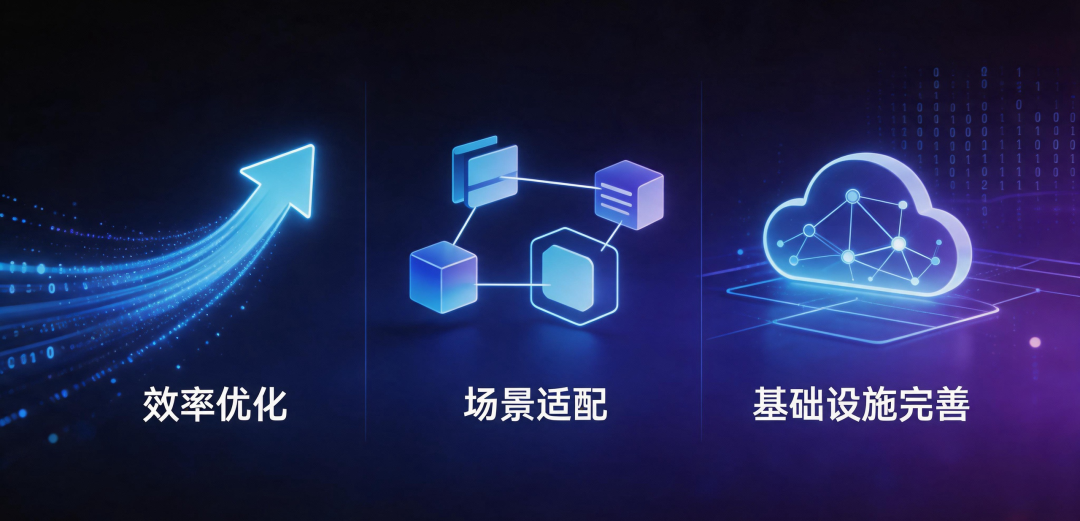
从目前的信息来看,答案或许在效率优化、场景适配与基础设施完善三个方向上。对于企业用户而言,这意味着模型选型的复杂性在增加,但可用性和性价比也在持续改善。
近期发布的这些模型中,您最关注哪一个?
在实际业务场景中,您认为模型能力提升带来的最大变化是什么?
欢迎留言交流。
免责声明:
本文基于OpenAI、字节跳动、百度、深度求索、Anthropic、网易有道、腾讯、华为等机构公开发布的产品信息及行业媒体报道撰写。文中分析观点为基于公开信息的独立判断,不代表任何厂商官方立场。具体产品性能和定价请以各厂商官方发布为准。
END
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撐。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享