当数据不再被动等待被消耗,而是与模型形成双向反馈、持续进化的关系,AI的“数据观”正在经历转变。
在AI的传统叙事中,数据常被比作“燃料”——模型燃烧数据产生智能,燃料越多、纯度越高,模型能力越强。
中国信通院发布的《人工智能模数共振体系研究报告(2026年)》提出了不同的视角。在模数共振体系中,高质量数据集不是静态的供给物,而是具备自我进化能力的动态主体。它通过闭环机制,能够接收模型反馈、识别自身缺陷、定向优化结构与内容。数据与模型的关系,正在从单向消耗走向双向互动。
上篇讨论技术范式之后,本文将聚焦数据价值层面,探讨高质量数据集的新角色与新定位。
01
高质量数据集的战略地位为何在提升?
过去一年,政策层面对高质量数据集的重视程度明显上升。
2025年8月,国家数据局启动高质量数据集建设先行先试;
2025年底,全国建成高质量数据集超10万个;
2026年4月,工信部与国家数据局联合启动“模数共振”行动。
这一系列动作背后,是对AI发展规律的再认识:在算法和算力趋于普惠的条件下,数据质量正成为影响模型能力上限的关键变量之一。
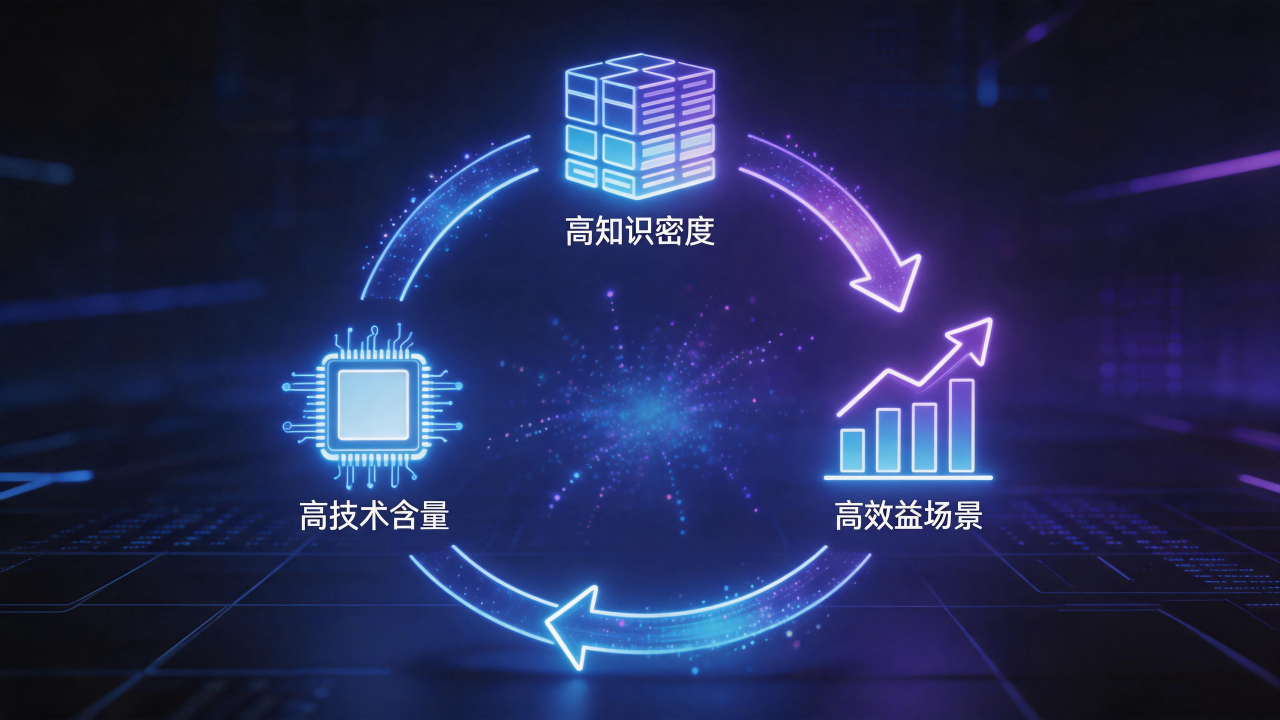
报告明确指出,高质量数据集是“高技术含量、高知识密度、高效益场景”的集合,其建设已超越单纯的“规模堆砌”,演进为一种动态的“闭环迭代生态系统”。
换言之,数据的价值不仅取决于规模,也取决于其“活性”——能否与模型持续互动、持续优化。
TalkingData洞察
“我们数据量很大,但不知道怎么用”。问题的关键不在规模,而在数据是否具备“可模型化”的质量——结构是否清晰、标注是否一致、长尾场景是否覆盖。报告提出的“高知识密度”点出了实质:单位数据中包含的行业机理和专家知识,相较于堆砌通用语料,往往具有更高的边际价值。
02
当前数据集在实际使用中有哪些提升空间?
全国数据生产总量已超过52ZB,高质量数据集建设也初具规模,但产业端依然持续需要可用、好用、敢用的数据集。以下几个方面值得关注:
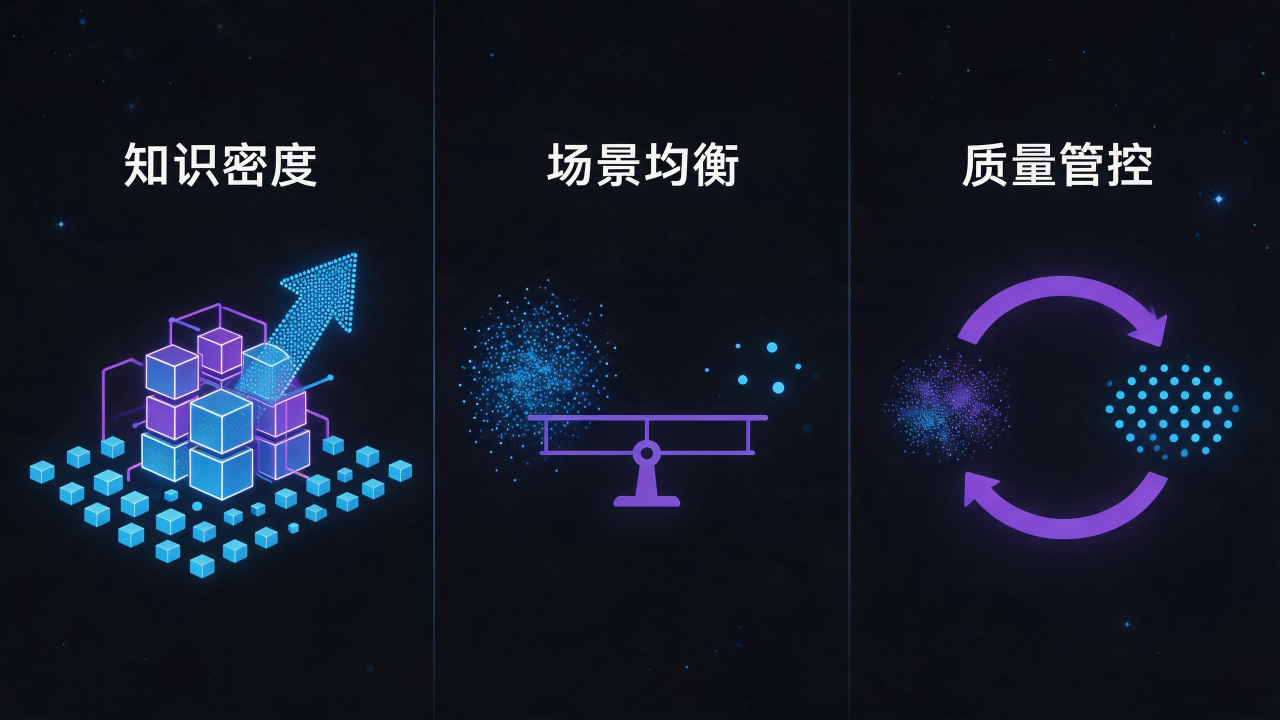
第一,数据集的知识密度有待进一步提高。
许多数据集停留在“信息堆砌”层面,缺乏深度的行业机理、专家知识与结构化标注。报告指出,高质量数据集应当形成“数据+知识”的复合型体系,例如在生物医药领域,有研究使用的蛋白质结构数据集集成了X射线晶体学、冷冻电镜成像等多学科实验数据。多数行业数据集距此尚有差距。
第二,场景覆盖的均衡性需要加强。
大量数据集偏向高频、通用、简单的场景,而极端、稀缺、长尾的场景数据相对缺失。这可能导致模型在真实业务中遇到“未见过的情形”时,表现出现一定波动。
第三,质量管控机制有待进一步完善。
标注错误、噪声数据、分布偏差等问题较为普遍,而有效的质量评估与反馈修正机制仍有待建立。数据集发布后,后续的更新和优化往往跟进不足。
这些挑战表明,数据集建设模式有待从阶段性交付向持续优化演进。模数共振体系为此提供了一种系统性的思路。
TalkingData洞察
在某些垂直领域,常见的情况是:高频、通用的数据覆盖较为充分,而低频、新出现的细分场景数据相对有限。在此情况下,模型在这些细分场景上的表现可能受到一定影响。一次性采集的覆盖范围有限,建立持续的样本补充机制是更可行的路径,这也正是闭环迭代的价值所在。
03
闭环迭代如何推动数据的持续优化?
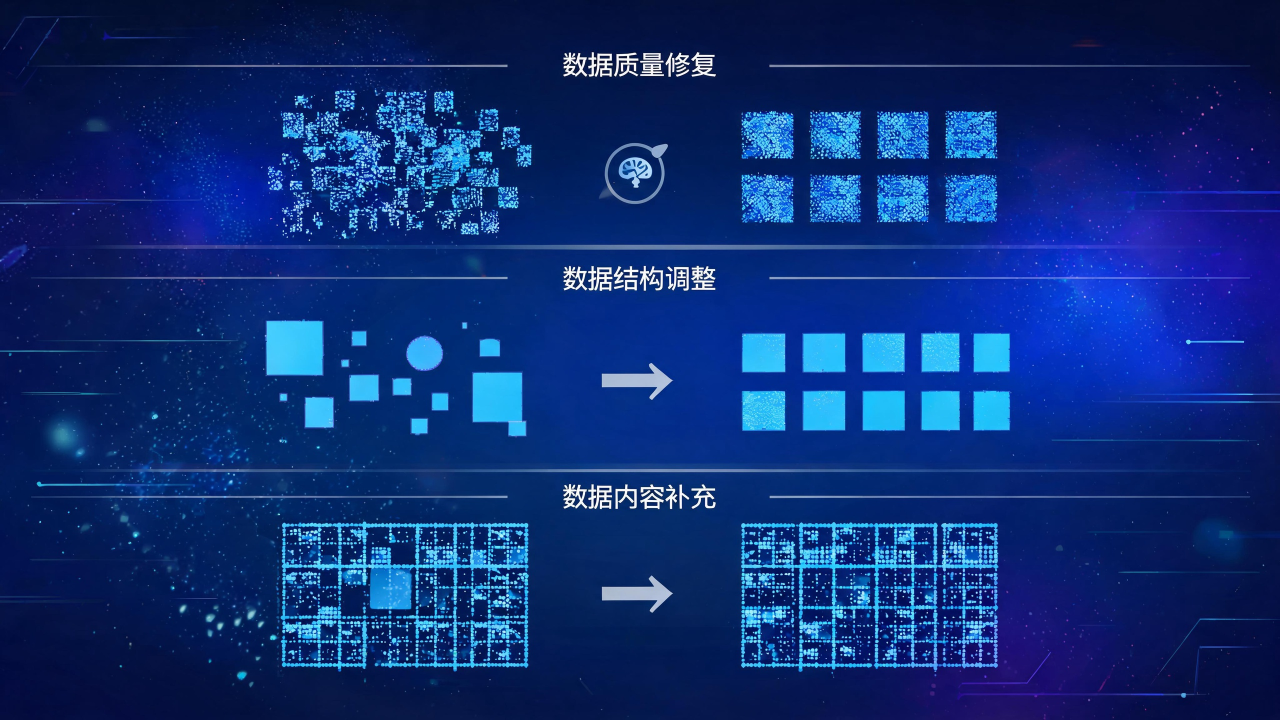
报告提出的数据闭环迭代机制,包含三个递进的优化层级。
第一层:数据质量修复。
当模型出现幻觉或逻辑偏差,通过归因分析可以定位到具体的数据问题——可能是某类样本的标注偏差,也可能是某类特征的噪声偏高。然后回溯至数据源头进行定向清洗和修正。
第二层:数据结构调整。
当模型在特定类别上表现不均衡,可以通过重采样或长尾场景挖掘,优化数据集的类别分布和特征空间覆盖度。
第三层:数据内容补充。
当模型泛化能力有待提升,无法有效处理未曾见过的场景时,可以利用合成数据生成或跨域数据融合,填补关键场景的知识盲区。
更重要的是,这些优化不是一次性的。报告强调,数据处理规则本身也会迭代。例如,发现某一领域术语识别率偏低时,不仅要补充相关数据,还要更新分词规则、实体抽取模板及标注规范。这种从“治标”到“治本”的规则演进,有助于数据生产的标准化水平随技术发展逐步提升。
TalkingData洞察
在数据标注规范的演进过程中,可以发现类似规律。初期以通用标准为主,随着模型在实际业务场景中的表现反馈,逐步发现某些标签定义范围过宽、某些长尾特征存在缺失,于是反过来修订标注手册、增加细分类别、优化抽样策略。数据标准不是一次性制定的,而是在闭环使用中逐步完善的。
04
数据闭环价值的产业验证
报告显示,数据闭环迭代在多个领域已取得可量化的成效。
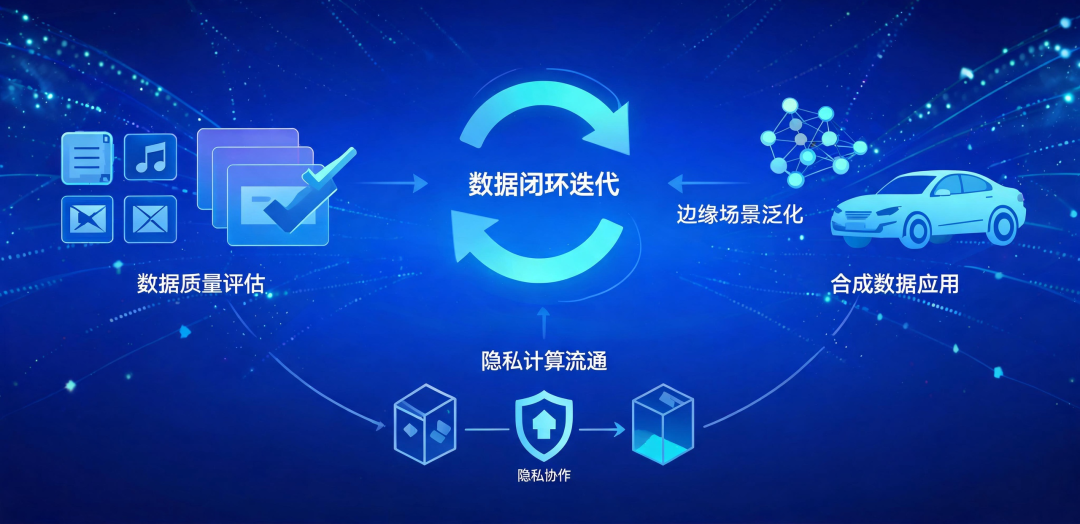
在数据质量评估方面,“可信AI人工智能数据集质量评估体系2.0”已覆盖文本、图像、音频、视频、多模态等数据类型,通过分层随机抽样与自动化评估工具,可系统识别数据集在完整性、准确性、一致性、多样性等方面的质量短板。基于评估反馈,部分数据集经过定向优化后,在模型训练中的有效利用率明显提升。
在合成数据应用方面,利用生成对抗网络或扩散模型,可以模拟极端天气、罕见故障、长尾用户行为等稀缺场景。例如在自动驾驶领域,合成数据技术被用于生成暴雨、暴雪等极端驾驶环境数据,有效补充了真实采集难以覆盖的场景。这类合成数据集经过质量校验后,可显著提升模型在边缘场景下的泛化能力。
在隐私计算与数据流通方面,通过差分隐私、联邦学习等技术,可以在不暴露原始数据的前提下完成跨机构的数据协作与模型训练。这一方向为医疗、金融等高敏感领域的数据集建设提供了新的技术路径,部分试点项目已实现多方数据的安全融合与质量协同优化。
这些实践表明,数据集不仅是静态的资产,更可以通过闭环迭代机制持续提升其可用性和价值密度。数据的“活性”正成为衡量数据资产质量的新维度。
TalkingData洞察
数据集的价值不仅体现在规模上,更体现在其是否具备被持续优化、被多场景复用的能力。建立数据质量评估与闭环反馈机制,可以帮助企业更系统地识别数据短板、更高效地推动数据资产增值。这一过程需要评估工具、合成技术、隐私保护等多方面的协同支撑。
数据资产化的下一步关注点?
报告指出,高质量数据集的建设正从“被动供给”向“主动适配”转型。未来的数据工程,不仅要服务于单次训练,也要构建能够持续接收反馈、自动触发优化、不断迭代的数据生产体系。
这对企业意味着两个可以关注的方向:
1、重新审视数据治理的战略定位。
数据治理不应只关注合规和存储,而应成为AI能力的核心组成部分。数据集的质量评估、闭环迭代、规则演进能力,将直接影响模型能力的天花板。
2、增加对数据工程工具与人才的投入。
报告提到的自动化标注、主动学习、合成数据、隐私计算等技术,正在从“可选”走向“必要”。同时,既懂行业业务、又懂数据科学和模型机理的复合型人才,预计将更加稀缺。
数据不是一次炼成的“成品”,而是需要持续浇灌的“活物”。率先建立数据闭环迭代能力的企业,可能在AI竞争中占据更有利的位置。
免责声明:
本文基于中国信息通信研究院人工智能研究所公开发布的《人工智能模数共振体系研究报告(2026年)》撰写,引用内容已标明出处。文中所有分析、观点及解读均为基于公开信息的独立判断,不代表报告编制单位或任何其他机构的立场。文章内容仅供参考,不构成任何投资或决策建议。
下一篇预告:
技术范式有了,数据价值清晰了,但这些最终需要落实到产业中。模型如何真正发挥作用?模数共振体系为产业落地提供了怎样的框架?下一篇将从产业落地角度进行解读。
END
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撐。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享