近日,中国人工智能产业发展联盟(AIIA)与大数据技术标准推进委员会(CCSA TC601)联合发布了《本体智能研究报告(1.0)》。报告明确提出一个关键定位:本体智能是大模型与业务系统之间的语义中间层。
为什么需要这个“中间层”?
大模型进入行业时,一系列现实问题逐步暴露——回答中出现事实偏差、业务术语理解出错、不同系统的数据难以打通。通用大模型基于海量通用数据训练而成,固然能说会道,但行业场景里那些约定俗成的概念、藏在业务流程里的规则,它很难凭空学会。
本体的作用,就是把这些行业知识系统性地梳理出来,让分散异构的业务数据变成机器可以理解、可以推理的结构化语义资产。
什么是本体智能?
在展开讨论之前,有必要先厘清一个基础概念:本体智能究竟是什么?
通俗地说,本体智能是在通用大模型与企业业务系统之间搭建的一个“语义中间层”,通过“本体建模”把行业里分散杂乱的数据,梳理成机器能读懂、能推理、能校验的结构化知识资产。
很多企业有一个常见误解:业务系统跑了好几年,沉淀了大量数据,简单清洗一下,就是“高质量数据集”。但实际上,原始数据更像是业务过程的“流水账”,字段名不同部门叫法不一,业务口径各有各的理解,逻辑规则藏在人脑里而不是系统里。机器能读出数据内容,却读不懂数据背后的业务含义。
本体建模做的事情,就是把这些零散的记录,通过统一的概念框架组织起来,让数据从“可读”变成“可推理、可校验、可溯源”,让大模型拿到之后能准确识别、正确使用。
那么,本体智能和高质量数据集是什么关系?
本体智能是高质量行业数据集的“加工标准”和“质量底座”。过去行业建数据集侧重汇集、清洗、去重、格式化,关心的是数据“干不干净”。但干净不等于机器能读懂,不同系统的“客户”含义不同,同一字段各部门口径各异,这些语义层面的问题,清洗解决不了。
本体智能增加了一道“语义加工”工序:梳理概念、统一术语、明确关系、刻画规则。经过这道工序,数据从“干净”升级为“可推理、可校验、可溯源”的知识资产。而且这套知识独立于模型存在,业务规则变了,更新本体即可,无需重新训练大模型。数据治理的内涵也因此从清洗去重延伸到了概念对齐与逻辑校验。
TalkingData洞察
不少企业把原始数据当成了数据资产,但术语混乱和口径不一致不是清洗能解决的。原始数据直接喂给大模型,业务层面的偏差很难避免。本体智能在中间起到了“翻译整理”的作用——把原本各说各话的数据,映射到统一框架下,变成模型能正确理解的语义资产。这个环节在行业数据建设中经常被忽视,但它恰恰决定了AI能不能真正用起来。
软知识+硬知识,大模型才更靠谱
通用大模型的知识来自统计规律,看过无数文本后,学会词语之间的关联。这种“软知识”让它擅长表达与生成,但在需要严格遵循业务规则的专业场景中,偶尔会出现与事实不符的“幻觉”。
本体智能补的,恰恰是“硬知识”,经过专家校验、形式化定义的概念、属性和业务关系,可审计、可追溯。
那么,软知识与硬知识如何协同?
大模型负责理解问题、生成内容,本体则负责提供确定的知识与逻辑约束,两者各司其职,共同让AI输出更可信。
这套组合在实际中双向发挥作用:向上,为RAG应用提供可信的知识底座,帮助约束模型输出、减少幻觉;向下,对接业务系统,把AI生成的文本指令翻译成系统能执行的操作,打通“说到”和“做到”之间的链路。
TalkingData洞察
通用模型掌握统计层面的软知识,本体沉淀专家确认的硬知识。二者结合不是替代数据集,而是做语义层面的“升维”。一方面给RAG和行业智能体提供可靠的知识底座,另一方面让AI输出能真正驱动业务系统——这是从“能聊天”到“能干活”的关键一步。
知识独立迭代,不再“牵一发而动全身”
本体智能给高质量数据集建设带来了几个值得关注的新思路:
治理对象在延伸。 过去只关心单条数据准不准、全不全,现在还要关心概念定义是否统一、不同系统的术语是否对齐。
治理内容在扩展。 除了数据字段校验,还要对实体之间的业务关系和约束规则做逻辑校验。
知识与模型解耦。 领域知识沉淀在本体里,独立于大模型存在。业务规则变化时,只需要更新本体模块,不需要重新标注数据、重新训练模型。
本体支持模块化和版本化管理,业务规则调整后,改本体就行了,不用每次都“重训一遍大模型”。当然,本体建模目前仍然高度依赖行业专家的深度参与,建设成本不低。如何借助技术手段让本体构建更自动化、更低门槛,是行业接下来需要攻关的方向。
TalkingData洞察
知识与模型分离的模式,最大的好处是降低了AI落地的迭代成本。业务规则变了,改本体就好,不用每次从头训练模型。但本体构建确实依赖行业专家,成本偏高。未来如何用技术手段降低门槛,让更多企业用得起来,是产业需要共同解决的课题。
产业链各方,各有各的课题
本体智能给高质量数据集建设带来了几个值得关注的新思路:
治理对象在延伸。 过去只关心单条数据准不准、全不全,现在还要关心概念定义是否统一、不同系统的术语是否对齐。
治理内容在扩展。 除了数据字段校验,还要对实体之间的业务关系和约束规则做逻辑校验。
知识与模型解耦。 领域知识沉淀在本体里,独立于大模型存在。业务规则变化时,只需要更新本体模块,不需要重新标注数据、重新训练模型。
本体支持模块化和版本化管理,业务规则调整后,改本体就行了,不用每次都“重训一遍大模型”。当然,本体建模目前仍然高度依赖行业专家的深度参与,建设成本不低。如何借助技术手段让本体构建更自动化、更低门槛,是行业接下来需要攻关的方向。
结语
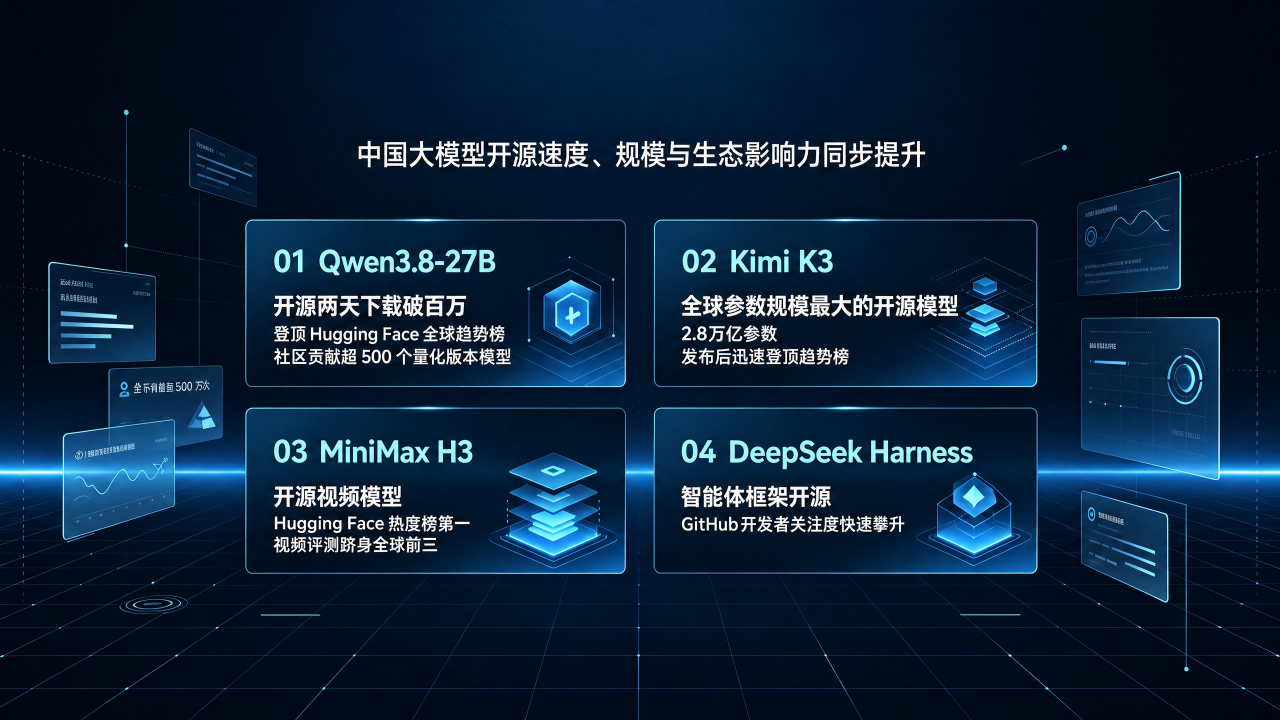
从 Hugging Face 高管的公开判断,到 Meta 加大开源投入,再到国产开源模型在国际社区收获高热度,开源 AI 的攻守易势已经成为值得关注的产业现象。
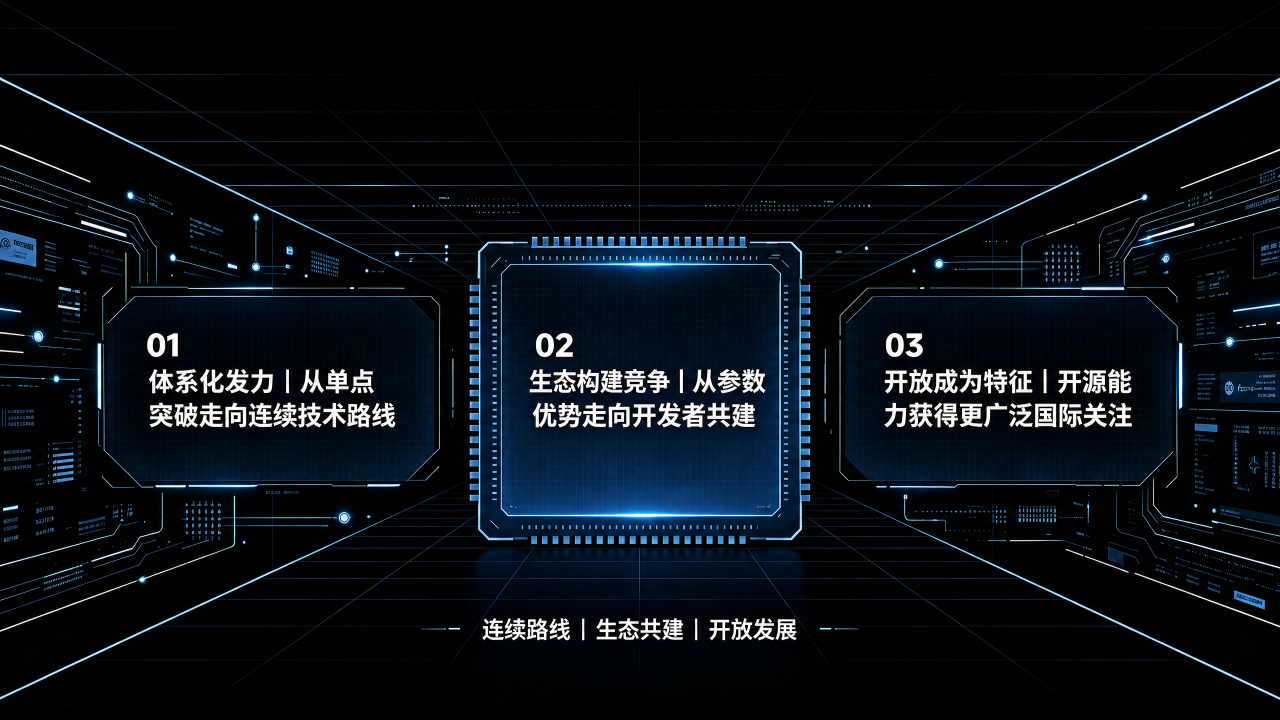
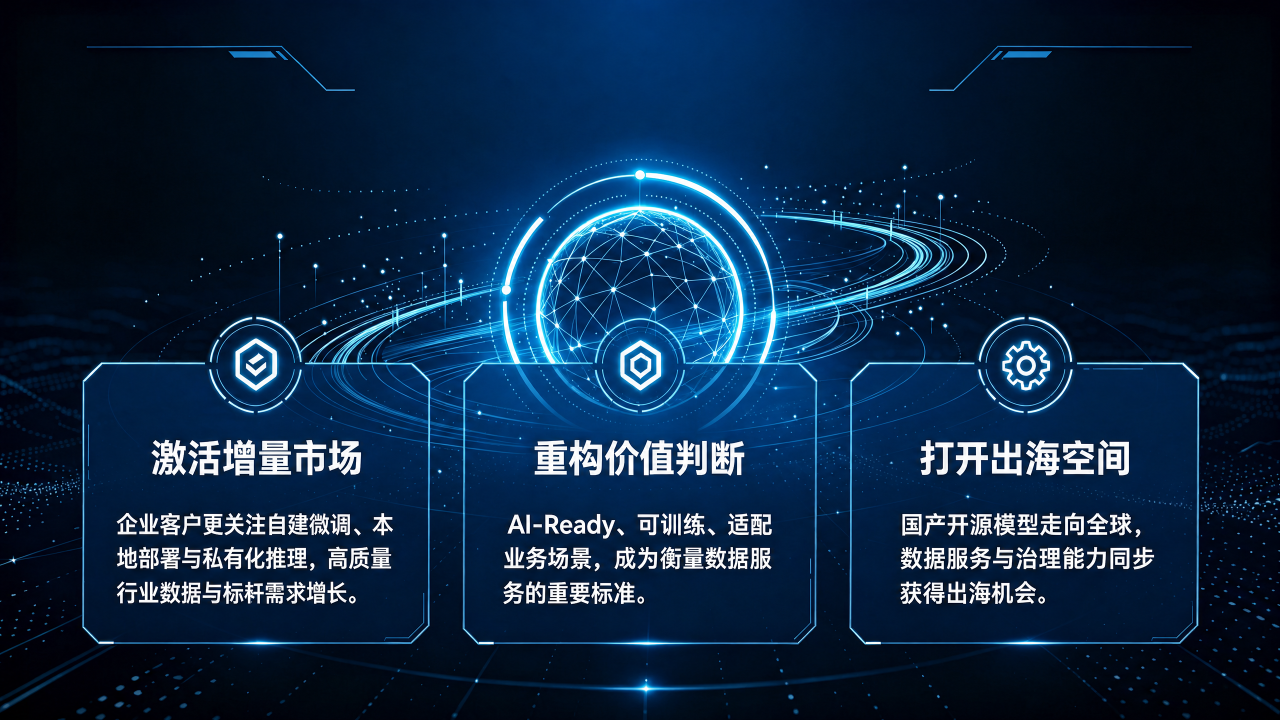
模型开放降低 AI 能力获取门槛,但 AI 产业的竞争并未因此简化。竞争从模型能力单点比拼,延伸到生态、算力效率、高质量数据、行业落地的全链条。开源基座模型越普及,高质量数据集、数据治理、合规数据服务的底座价值就愈发凸显。
对于数据服务企业而言,开源浪潮既是机遇也是挑战:市场需求在扩张,但行业的评判标准也在升级。只有同步夯实数据质量、AI 就绪加工能力、合规服务能力,才能更好地都服务于 AI 产业。
免责声明:
本文基于Hugging Face公开报告、CNBC采访、潮新闻、界面新闻等公开信息撰写。文中分析观点为基于公开信息的独立判断,不代表任何官方立场。
END
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撑。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享