6月8日,国家数据局发布《关于推进行业高质量数据集建设行动的实施方案》(以下简称方案),围绕行业高质量数据集供给、流通、应用等关键环节,部署强基扩容、标注攻坚、提质增效、应用赋能、管理服务、价值释放六大专项行动。这是国家层面首次对数据赋能人工智能发展作出的系统性部署。
《方案》明确,面向人工智能应用需求,持续推进文本、图像、音视频等多模态高质量数据集建设;聚焦科学研究、工业制造、低空经济、具身智能等重点领域,加快推进行业高质量数据集建设;引导具备条件的地区因地制宜开展数据标注创新试验区建设。
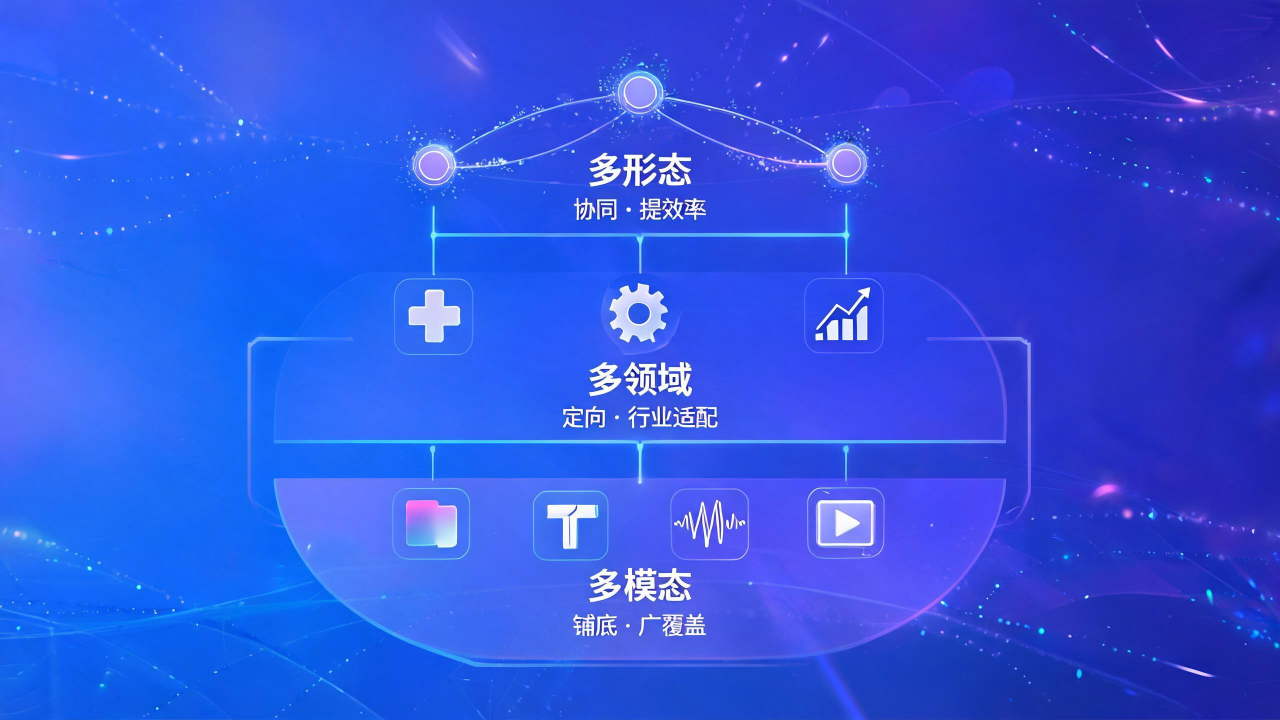
这实际上描绘了一幅高质量数据集建设的“立体化”路线图:“多模态”铺底,解决数据形态的广覆盖问题;“多领域”定向,解决数据质量的行业适配问题;“多形态”协同,解决数据生产方式的效率问题。三者彼此支撑。
行业高质量数据集是推动“人工智能+”赋能千行百业的基础性、关键性资源。把数据定位为“核心资产”,是为产业打地基的长期布局。对于数据服务企业而言,围绕垂直场景构建可复用、可评估的数据资产,将是参与这一进程的务实路径。
01
多模态:
从文本到物理交互,拓展数据形态
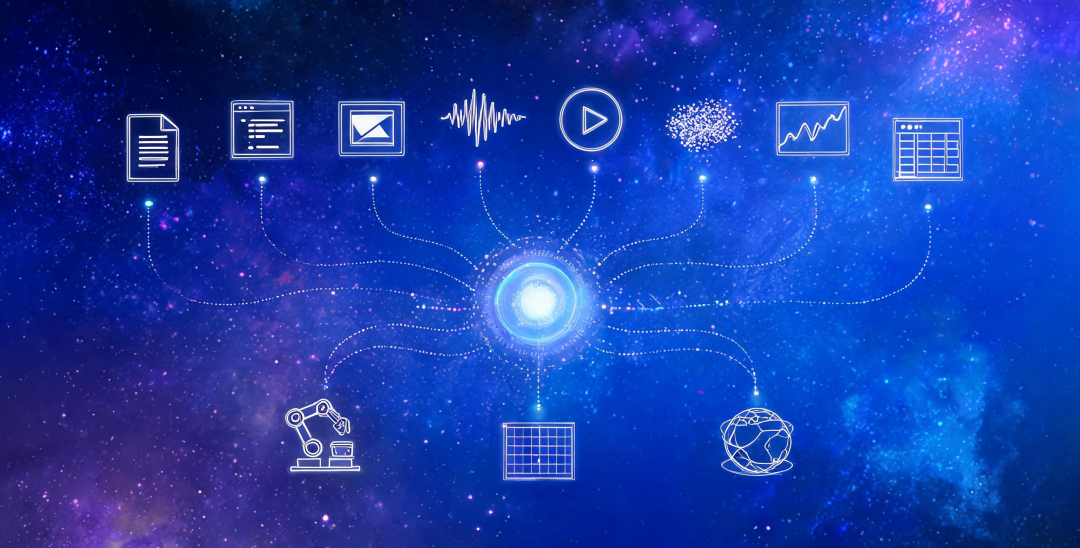
方案提出持续推进文本、代码、图像、音频、视频、点云、时序数据、科学数据等多模态高质量数据集建设,赋能AI预训练、指令微调、强化学习、测评等各阶段。同时,加快重点场景物理交互、环境感知、运动控制等真机交互数据集建设,积极应用仿真模拟与合成技术扩大数据供给,赋能具身智能发展;积极面向世界模型等前沿方向推进数据集建设。
具身智能方向已有实践呼应方案方向。6月3日,智元机器人正式开源AGIBOT WORLD 2026数据集第二期“多样交互”主题,系统记录机器人与真实物理世界之间复杂、高密度、非理想的交互过程。与传统数据集中只关注“成功示范案例”的采集逻辑不同,智元此次开源的“多样交互”主题数据集主动保留并强调非理想行为的研究价值,将具身智能的数据范式从“学习成功动作”推进到“理解完整的物理分布”。
TalkingData洞察
“多模态”不只是增加几种数据类型,其核心变化在于从符号世界走向物理世界。当数据集的类型从文本、图像延伸到物理交互、空间感知,AI模型才有可能真正理解现实世界。而物理交互数据的采集成本远超文本和图像,这对数据集供给方的技术和资源都提出了更高要求。
02
多领域:
从重点行业到创新前沿,聚焦场景适配
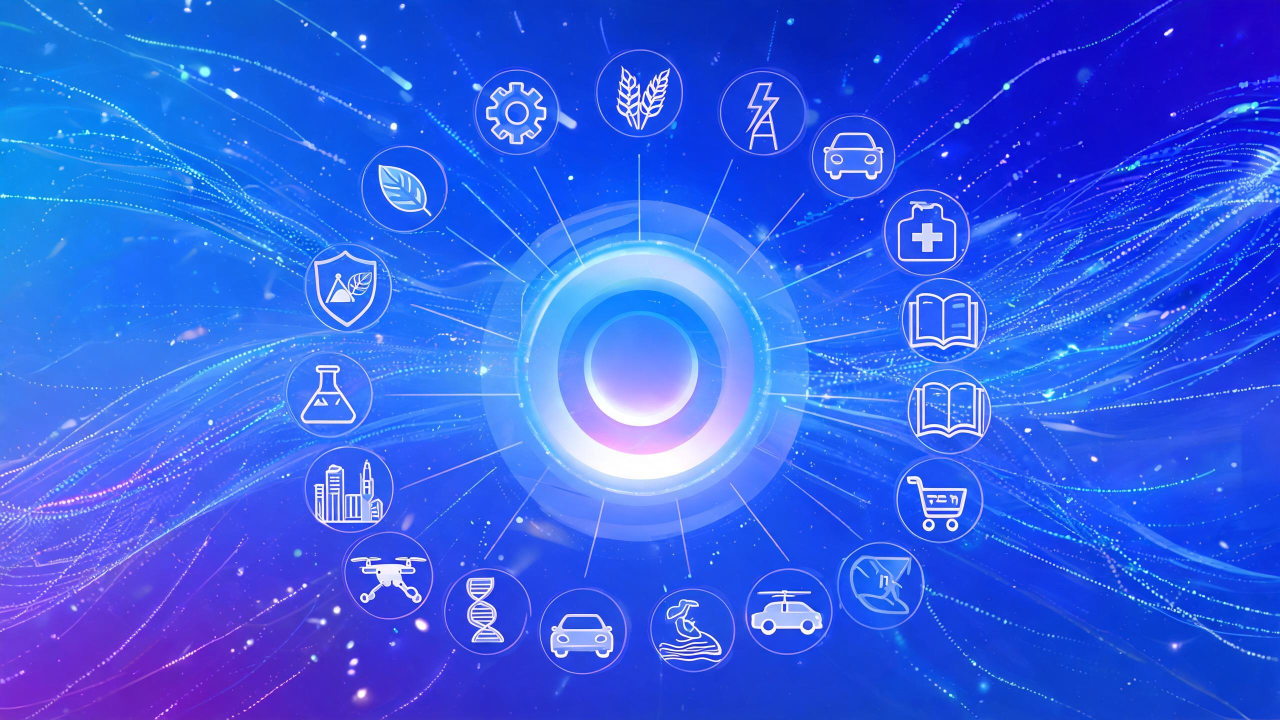
方案聚焦科学研究、工业制造、教育教学、电子商务等19个重点领域,以及低空经济、具身智能、智能驾驶、智慧海洋、生物制造等创新领域,加快推进行业高质量数据集建设。
在低空经济领域,深圳电信“低空监管运营高质量数据集建设”项目入选国家首批先行先试名单,汇聚气象、地理、航空器运行、安全感知等多源数据,形成静态与动态相结合的高质量数据集。
方案还提出“强化链主单位牵引带动作用”,支持链主单位以联合体等形式推动产业链上下游协同共建和资源整合,鼓励链主单位面向行业开放数据集并提供数据服务,赋能产业链上下游中小企业。
TalkingData洞察
前沿领域的数据集建设往往是“应用反推数据”的模式——场景中的真实痛点催生了数据需求,而数据的生产又进一步加速了场景的智能化升级。从现有实践看,成效较为明显的案例多集中在医疗影像、工业质检等具有高价值、高重复性特征的专业场景。
03
多形态:
从人工标注到人机协同,升级标注模式
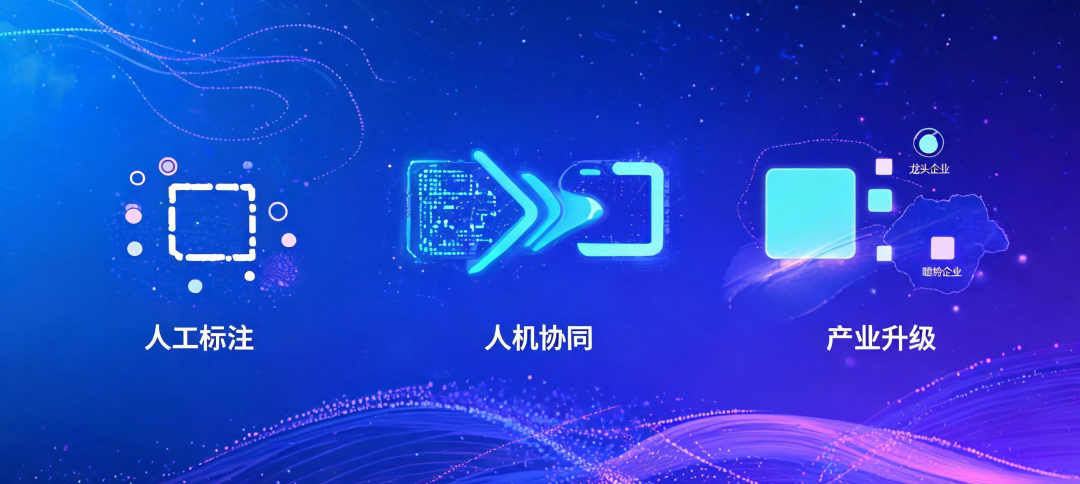
方案提出,推动数据标注从“以人为主”向“人机协同、专家深度参与”的多层次标注模式转变,培育一批数据标注龙头企业、独角兽企业、瞪羚企业,壮大数据标注产业。同时,面向创新能力强、发展基础好、产业特色优的地区,梯次布局一批数据标注创新试验区。
目前,国家已确定四川成都、湖南长沙等七个城市承担国家级数据标注基地建设任务。截至2025年3月,七个基地引进和培育标注企业223家,标注从业人员达5.8万人,带动相关产值超83亿元。
智能化标注工具将在数据清洗、预标注、质量校验等环节承担更重要的角色,有助于降低数据标注的人力投入成本,提高标注的准确率与一致性。
TalkingData洞察
数据标注的转型升级,不仅关乎成本,更关乎数据质量。从“人海战术”到“人机协同”,标注行业从劳动密集型转向技术驱动型的趋势已经显现。下一阶段的增长点可能在于AI辅助标注工具、专家知识沉淀机制,以及可用于跨行业复用的标准化标注质量评估体系。
04
政策与平台:
构建数据流通基础设施
此次方案与近期上线试运行的国家数据集管理服务系统形成呼应。
国家数据发展研究院院长胡坚波指出,该系统采用“物理分散、逻辑集中”的汇聚模式,在不强制数据出域的前提下,构建全国统一的数据集资源目录与管理体系,推动高质量数据集“供得出、流得动、用得好”。
方案落实了数据持有权、使用权、经营权三权分置制度。清华大学法学院教授表示,数据经营权与其他权利分离,有助于在保护各方权益的同时为数据价值释放预留空间。
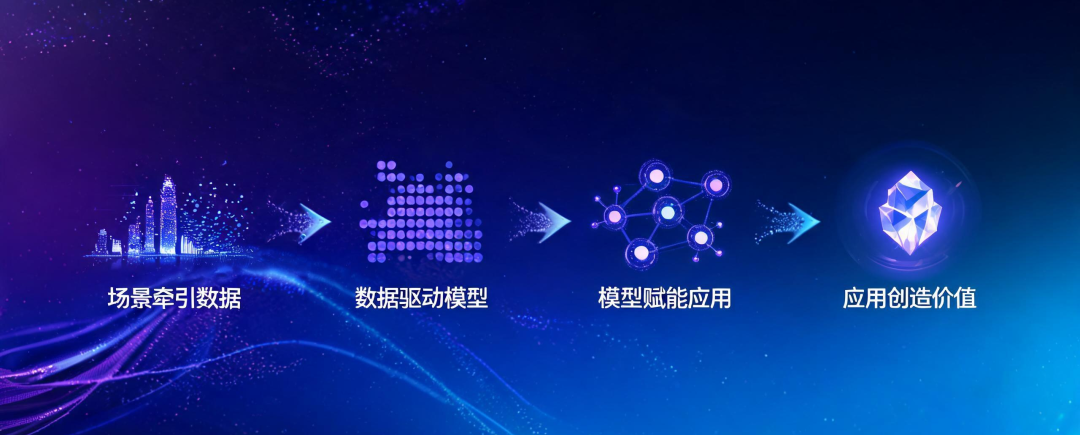
方案明确形成“场景牵引数据、数据驱动模型、模型赋能应用、应用创造价值”的“数据飞轮”,加快构建数据要素与人工智能协同演进的共生生态。
数据价值的最终落点是“被使用”。
政策层面为数据流通提供了制度框架,行业层面的关键是在具体应用中不断迭代,形成“数据→模型→应用→更多数据”的良性循环。对于数据服务企业而言,聚焦垂直场景、打造可复用的数据产品,是参与这一进程的可行路径。
您所在的行业需要什么类型的高质量数据集?
欢迎在评论区分享交流。
免责声明:
本文基于国家数据局公开发布的《关于推进行业高质量数据集建设行动的实施方案》及相关公开报道撰写。文中引用的国家数据局数据来源于国家数据局公开宣布;第三方机构预测值来源于研究报告,不代表国家数据局及方案原文的政策立场,请以官方后续实际发布为准。各地案例来源于公开报道。分析观点为基于行业实践经验的独立判断,不代表任何官方立场。政策具体落地成效,请以国家数据局及各地方、各行业主管部门实际发布为准。
END
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撐。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享