国家数据局数据大讲堂聚焦本体驱动,高质量数据集建设,正在从规模扩张走向语义结构化新阶段。
近期,国家数据局举办 2026 年第 14 期 “数据大讲堂”,主题为 “数据构筑韧性,本体驱动执行 —— 数据要素价值释放路径探索”。本次大讲堂围绕数据本体构建、跨域数据融合、数据协同治理等方向展开研讨,同时国家数据局持续推进高质量数据集建设六大行动,依托人工智能技术推动数据资源高效开发利用。一系列动向清晰显示:高质量数据集建设,已经走出单纯追求数据体量的阶段,迈向以本体为核心的语义化、结构化新阶段。
01
数据本体:
重新定义高质量数据集的建设逻辑
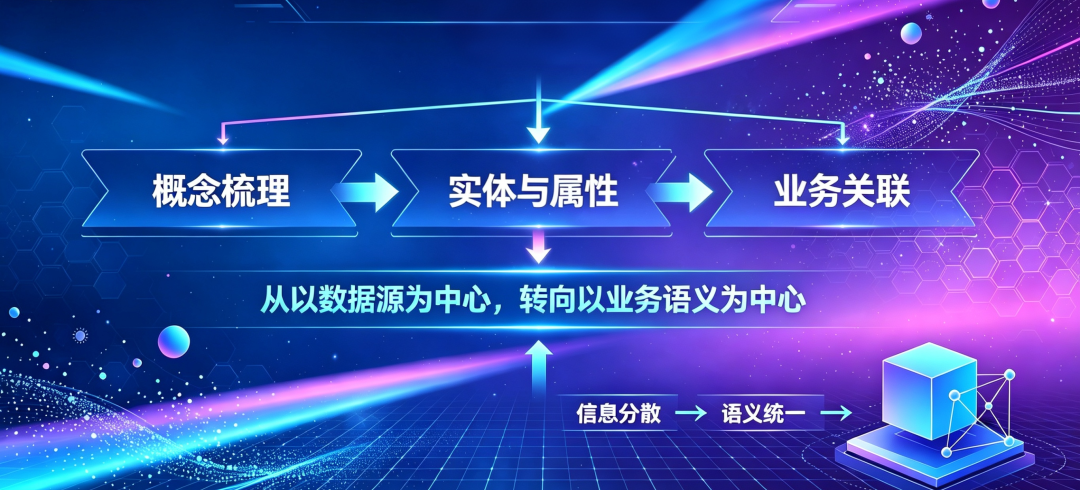
过去打造数据集,大多以数据源为中心,对各类原始数据进行采集汇总。这类模式容易出现数据总量大,但信息分散、含义不统一的问题。而数据本体,就是梳理行业内的概念、实体、属性与业务关联,建立一套统一的语义描述框架。
在本体思路下,高质量数据集不再是原始数据的简单汇总,而是承载业务知识的集合。数据集建设的重心,从 “收集尽可能多的数据” 转变为 “定义清晰统一的业务语义”,实现从以数据源为中心转向以业务语义为中心。
TalkingData洞察
评判高质量数据集的标尺正在改变,数据条数不再是唯一指标。本体构建,本质是为分散的数据建立统一的业务 “语言体系”。对于数据服务商而言,数据集治理能力,需要从基础的数据清洗加工,升级到行业语义建模能力,把零散原始数据沉淀为承载业务逻辑、支持推理的知识体系。
02
本体驱动,
破解高质量数据集的跨域 “语义孤岛”
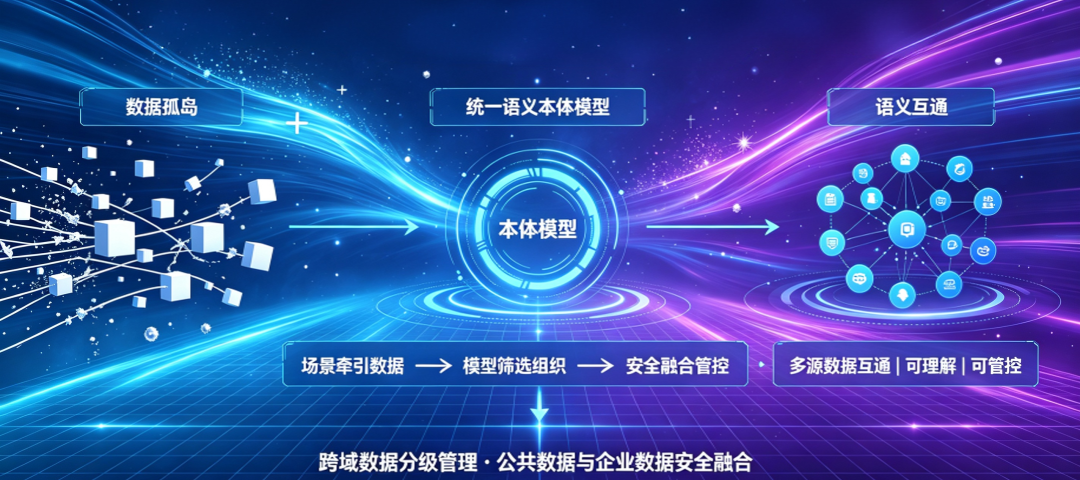
行业里常说数据孤岛,而更深层的难题是语义孤岛。不同机构、不同行业各自产出数据集,即便完成物理汇聚,相同名词含义不同、同类实体标识不统一,数据之间无法自动关联,跨域的数据融合很难落地。
本体驱动为高质量数据集建设提供了新路径:遵循 “场景牵引数据” 的闭环,先搭建统一语义本体模型,再依据模型筛选、组织数据。以此支撑公共数据与企业数据安全融合、跨域数据分级管理,让多源数据集能够互通、可理解、可管控。
TalkingData洞察
跨域数据集流通最大门槛之一就是语义不一致。本体驱动提供了解决方案:先统一语义共识,再推动数据流通。数据服务企业在搭建跨域高质量数据集时,需要前置做好行业本体梳理,才能真正释放多源数据融合价值。
03
面向新兴赛道,
打通价值释放“最后一公里”
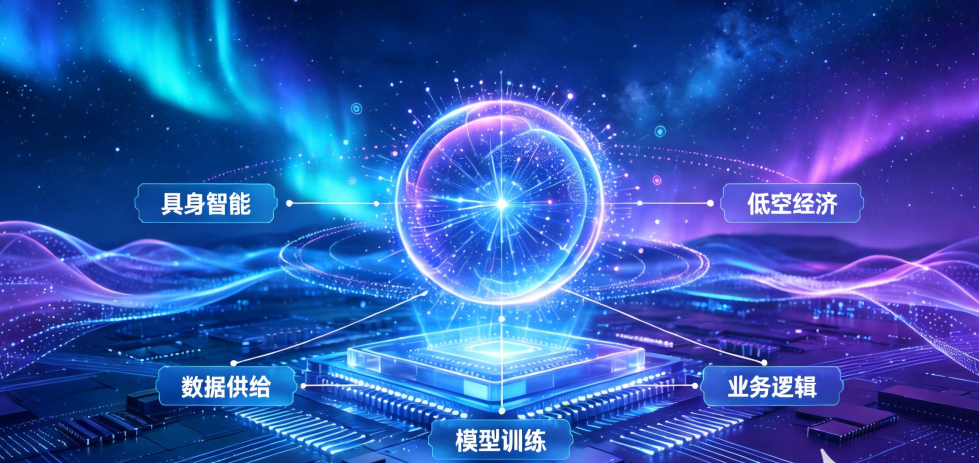
随着大模型向垂直行业深度落地,具身智能、低空经济等新兴领域,对高质量数据集提出全新要求。
这类新兴场景业务链条复杂,实体类型丰富,AI 模型不只是需要基础样本数据,更需要能够支撑逻辑推理的关联知识。传统堆砌式数据集,很难满足复杂场景下模型训练与业务落地需求。
依托本体构建语义一致、关联清晰的高质量数据集,固化实体、属性、业务之间的关联关系,让 AI 读懂业务逻辑,而不只是识别表层特征。由此打通从高质量数据供给、模型训练到业务落地的最后一公里,支撑新兴产业智能化落地。
TalkingData洞察
垂直行业 AI 落地,瓶颈正在从数据数量转向高质量数据集的语义质量与关联完整性。在具身智能、低空经济这类新赛道,行业本体建设将成为高质量数据集的标配能力,也是服务商切入新兴领域的重要抓手。
结语
这场围绕高质量数据集的 “语义跃迁”,核心变化可以概括为三点: 一是数据集建设逻辑,从堆砌数据,升级为搭建业务语义体系; 二是数据流通模式,从物理汇聚,升级为跨域语义互通; 三是价值评价标准,从看重体量大小,升级为看数据集能否支撑业务推理与场景落地。
随着高质量数据集六大行动持续推进,本体驱动会逐步走进更多行业实践。对于数据服务企业来说,语义建模、本体构建能力,将成为继数据治理、合规能力之后,打造高质量数据集的又一项核心基本功。
免责声明:
本文基于国家数据局公开发布的会议信息及公开报道撰写。文中分析观点为基于公开信息的独立判断,不代表任何官方立场。具体政策执行请以主管部门实际发布为准。
END
关注TalkingData,获取更多数据洞察与行业分析。
高质量数据集是未来AI 发展的支撑。
为人工智能提供所需的一切数据
Delivering Comprehensive AI Data for All Industries.
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享