随着互联网、物联网发展以及各种数字化终端设备的普及,2023年全球产生的数据量高速增长,且大部分是非结构化形态。要将原始形态数据,转化为机器可识别和学习的格式,数据标注服务应运而生。这两年生成式AI的突破性发展,更是带动数据标注从小众服务迅速成长为潜力巨大的产业。根据Grand View Research的报告,2023年全球数据标注工具和服务市场规模达85亿美元,其中,美国为28亿美元,占1/3,尤其数据标注工具更为突出,占全球市场接近40%。
数据质量是AI模型训练面临的最大挑战。据美国最著名数据标注服务公司Scale AI对其1300名从业者调查发现,三分之一表示他们遇到的首要问题是数据质量问题,其次是收集、分析、存储和版本控制问题。作为AI价值链的“上游”环节,没有高质量数据集,意味着“下游”就无法高质量建模,数据错误会转化为AI的偏见和误导性预测。高质量数据集开发和提供因此成为数据标注服务的核心竞争力。
随着人工智能技术渗透到生产生活中的每一个环节,“数据”成为AI创新最基础且最关键的生产资料。而为AI准备好“干净”“优质”“可信”的数据时,数据标注环节必不可缺。这一道工序好比为机器输入一份“答案”,帮助它更清晰地理解现实,为智能技术赋能更多领域创新。
数据标注行业现状
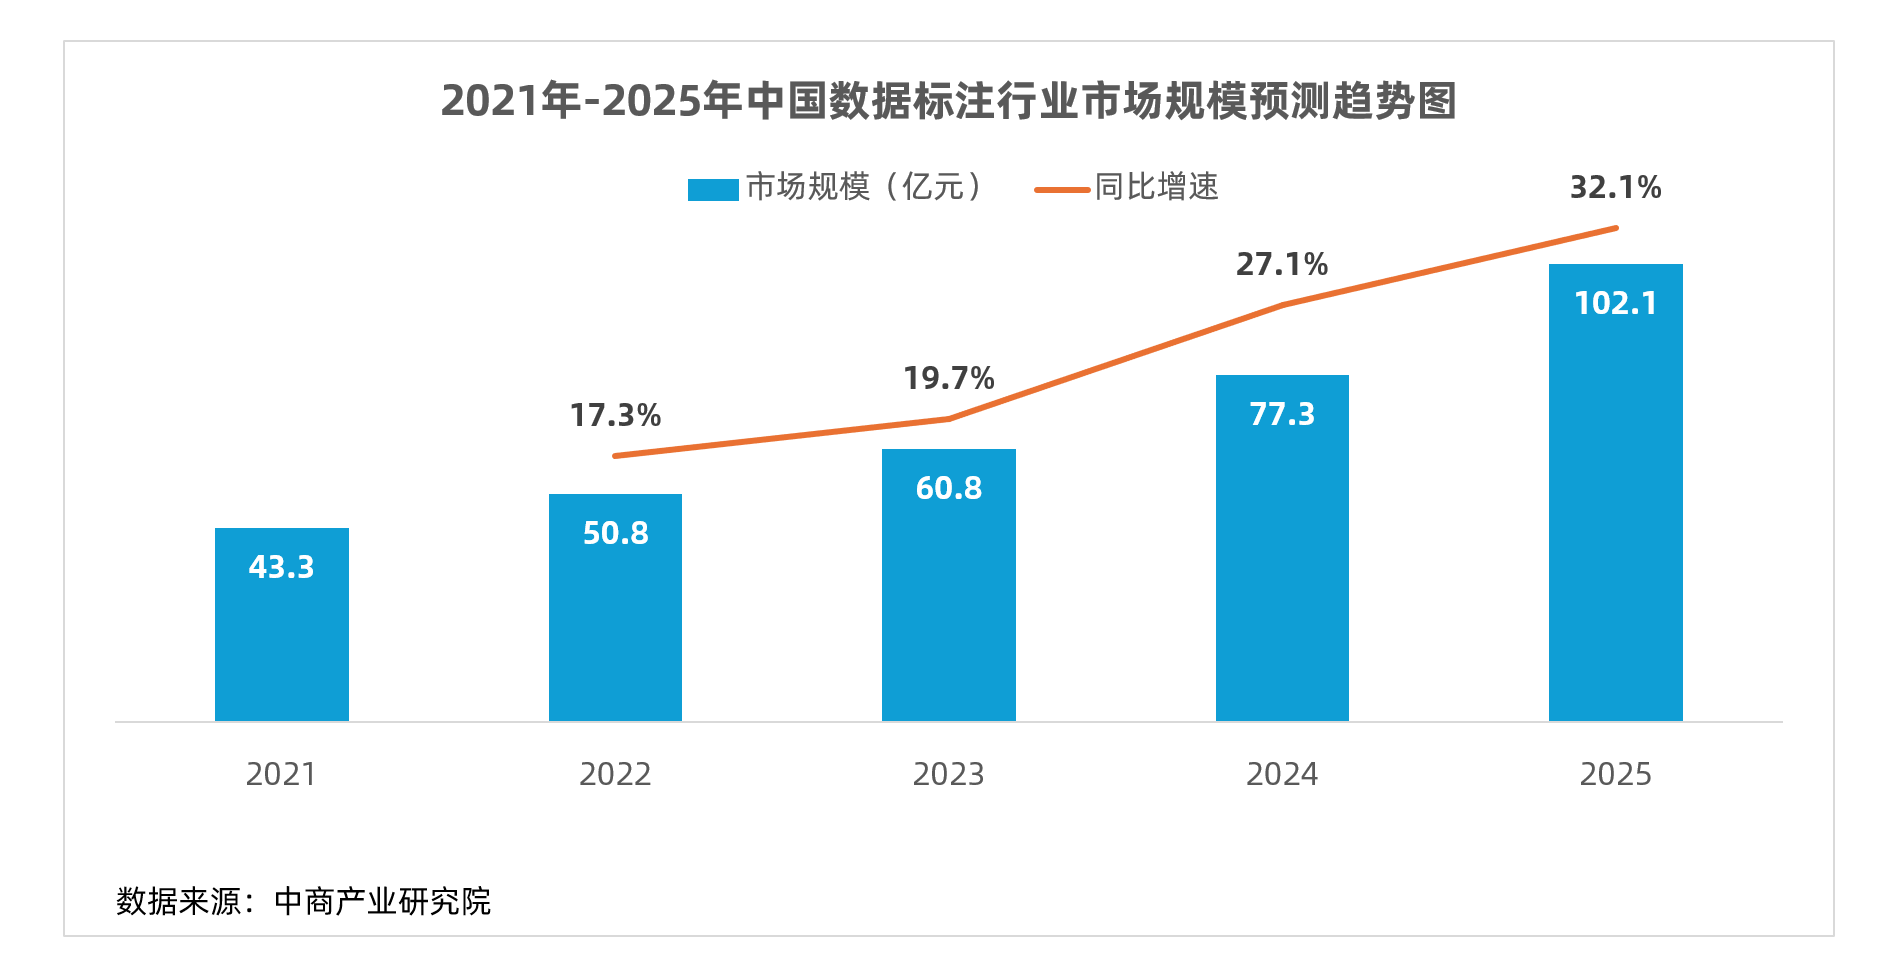
近几年来,中国数据标注产业正经历前所未有的高速增长期,成为人工智能基础设施的核心环节。根据中商产业研究院最新报告,2023年中国数据标注市场规模已达60.8亿元,同比增长19.69%,呈现稳步上升态势,而更为惊人的是市场预期的爆发性增长——预计到2025年,市场规模将跨越100亿元大关,达到102.1亿元(保守预测)。
这一增长背后的核心驱动力来自人工智能产业的蓬勃发展,特别是大模型训练对高质量标注数据的海量需求。2023年中国AI大模型市场规模已达141.34亿元,同比增长83.92%,预计2025年将飙升至495.39亿元,为数据标注行业提供了广阔的下游应用空间。
产业驱动力的多元化趋势同样值得关注。数据标注已从传统的互联网和科技行业扩展到多个高增长领域:在智能驾驶领域,标注需求涵盖车辆识别、道路识别、行人识别等复杂场景;医疗影像分析依赖肿瘤检测、病变识别等专业标注;智能安防则聚焦面部识别、人脸关键信息点提取等关键技术。而随着大模型向行业纵深发展,金融、法律、教育等知识密集型领域的专业数据标注需求呈现爆发式增长,推动行业向专业化、精细化方向演进。
随着AI技术渗透到智能驾驶、安防、机器人、自然语义理解等领域,需要为不同的数据提供高度准确且富有语义信息的标签。这种标签赋予机器以“认知”,从而显著提升模型的鲁棒性和表现。
行业痛点与技术挑战
尽管前景广阔,数据标注行业仍面临多重挑战,制约着产业的高质量发展:
01 场景化能力不足
不同应用场景对标注提出高度差异化要求。自动驾驶需要处理复杂的3D点云标注和多传感器融合数据;医疗影像分析则需专业的病理知识和病灶识别能力。传统标注企业缺乏跨领域专业知识积累,难以满足这些高门槛需求。
02 质量与效率瓶颈
AI模型训练对数据质量要求极高,当前行业普遍要求99% 甚至99.99% 的标注准确率。然而,依赖人力的标注模式难以同时兼顾效率与质量。业内领先企业如景联文科技通过AI预标注技术将效率提升3倍以上,但该技术尚未普及。
03 数据安全隐忧
随着《数据安全法》的实施,数据隐私保护成为行业生命线。安防、医疗等领域涉及大量人脸、健康等敏感信息,传统标注平台在数据传输、存储环节存在泄露风险。联邦学习等隐私计算技术的应用仍处于早期阶段。
04 人才结构失衡
粤港澳大湾区调研显示,当前数据标注岗位以基础标注员(68.18%) 为主,而AI训练师(15.13%) 和大模型标注专家(3.34%) 等高端人才严重短缺。全国范围内,专业数据标注人才缺口超过100万,呈现“低端过剩、高端短缺”的结构性矛盾。
05 技术复杂度挑战
从设备唯一性识别、数据标准化到分析算法,每个环节都存在技术“深坑”。以移动端设备识别为例,国内安卓系统碎片化严重,超过2万款不同系统版本需要针对性适配;而简单的运营商字段识别,仅“中国移动”就有200余种不同字符串表达。这些底层技术挑战需要长期投入和专业团队才能攻克。
政策赋能数据标注产业
近年国家高度重视数据基础资源对产业升级的作用,陆续推出一系列重大战略规划,为数据标注产业营造出良好基础条件:
- “数据基础制度”(数据产权、数据授权、数据交易)为数据生产主体提供法律基础。
- “人工智能重大科技专项”、“新基建”、“数字经济” 等重大战略为数据生产赋能。
- 数据安全法、个人信息保护法为数据生产制定清晰规范,形成可信的数据生产生态。
2024年,国家发改委等四部门联合发布《关于促进数据标注产业高质量发展的实施意见》,明确提出到2027年,数据标注产业规模大幅跃升,培育一批具有影响力的科技型数据标注企业,形成相对完善的产业生态,产业规模年均复合增长率超过20% 的宏伟目标。这一顶层设计为行业发展指明了方向,而技术创新将驱动产业升级。未来几年,数据标注行业将呈现三大趋势:
自动化与智能化:AI辅助标注、智能质检技术普及,形成“机器预标+人工精修”的高效工作模式,预计效率提升50% 以上。
专业化与标准化:针对垂直领域的专业标注需求催生细分市场领导者;国家标准、行业标准、团体标准协同推进的标准化体系加速形成。
生态化与国际化:产业链上下游协同加强,构建“算法—数据—应用”闭环生态;国内企业积极参与国际竞争,引进先进技术和管理经验。
随着技术进步与法律法规的不断健全,中国数据标注产业有望形成规范化、规模化、智能化的新生态,为人工智能技术创新输入更多优质的数据基础。
TalkingData的数据标注战略布局
面对这一重大机遇,TalkingData依托自身的数据生产能力和技术基础,形成了一体化的数据标注战略:
1. 智能生产:依赖机器辅助标签技术(半自动标签、智能校验),显著降本增效。
2. 高度标准化:制定标签规范、生产标准、审核体系,保障数据标签的一致性和可信度。
3. 数据安全:采取数据脱敏技术、授权管理和访问控制,确保数据生产过程完全合规。
4. 生态联合:联合上游数据供应伙伴、下游AI技术公司,共同打造数据生产生态圈,为人工智能赋能更多垂直领域。
数据是AI技术创新中最基础且最关键的生产资料。随着技术进步、法律法规日益健全,数据标注产业必将向着规范化、智能化和规模化稳步推进,为人工智能赋能更多的创新实践。这其中,TalkingData愿以数据为基础,与伙伴携手共进,为产业升级增砖加瓦,为中国人工智能产业增效赋能。
END
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享