近年来,大模型技术的飞速发展正推动AI从“可用”走向“实用”,但在狂飙突进的背后,训练数据的合规问题正悄然演变为一场潜在的危机。
版权清洗难、数据质量失控、溯源困难,成为模型开发过程中不得不正视的现实风险。
ONE
数据合规:大模型产业的“灰犀牛”
大模型训练依赖的是TB甚至PB级的文本、图像、音视频等多模态数据,其中包含大量来自网络、开源社区、用户生成内容等来源的数据。过去,行业往往默认“抓取即可用”,但随着《著作权法》《个人信息保护法》以及《生成式人工智能服务管理暂行办法》等政策逐步落地,数据合规被正式写入算法产业的底层逻辑。
2023年,《生成式人工智能服务管理暂行办法》第七条明确指出:训练数据应合法取得,不得侵害他人知识产权。
这一政策红线,正在重塑AI开发的行业基础。
近几年,包括OpenAI、Stability AI、GitHub等企业均因训练数据引发版权诉讼,数据合规已成为模型能否上市商用的核心门槛之一。
企业不能再将数据问题视作技术附属,将数据风险外包给“来源方”,而必须将“数据治理”提升到与“算法研发”同等重要的战略高度,建立起覆盖采集、清洗、存证、使用全过程的数据治理体系。
TWO
版权清洗:构建“可用+可证”的数据池
所谓“版权清洗”,本质上是将数据中可能存在版权风险的内容进行识别、分类、替换或剔除,确保训练数据不侵权、不违规。
传统做法往往采用关键字匹配、简单黑名单剔除等方式,但这种方式易漏判、误判,且无法溯源与举证,难以在法律层面自证清白。
当前行业正在向更智能、系统的清洗方式演进:
智能识别模型嵌入:基于NLP或图像识别模型,识别数据中可能存在的受版权保护内容(如书籍、新闻报道、影视片段等);
权属溯源系统搭建:将数据源信息结构化记录,实现“数据来源可查询、使用范围可控”;
自动合规标签体系:结合元数据和规则库,对数据打上“许可用途”、“再使用限制”等标签,实现按需筛选。
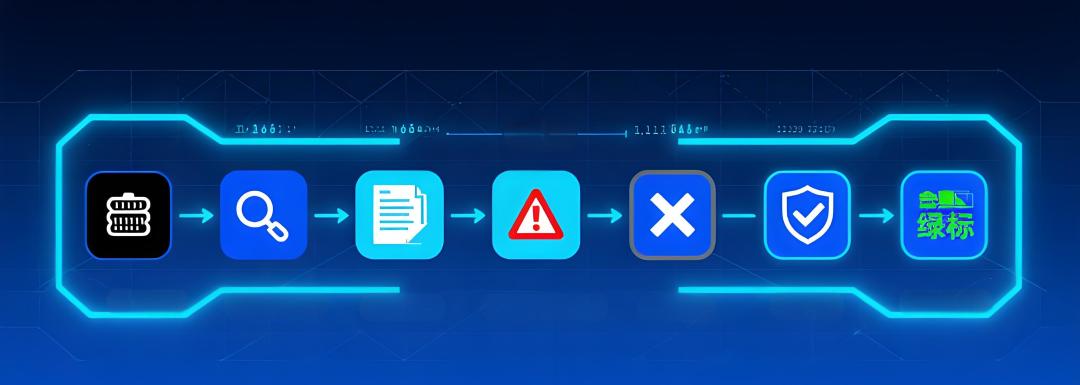
部分头部企业已通过合作或采购方式引入“版权清洗即服务”平台,实现大规模数据预处理。
TalkingData作为国内专业的数据服务平台,通过整合数据确权、数据映射、风险筛查等能力,已逐步构建成熟的数据资产清洗与授权解决方案,在合规成本高企的背景下,帮助客户高效构建“可商用、可交付、可审计”的训练数据集。
THREE
质量校验:模型好坏,先看数据水线
除了版权问题,大模型训练中另一个不可忽视的风险是“垃圾数据泛滥”——这直接影响模型输出的准确性、公平性与稳定性。
如果说版权合规决定了模型能否商用,数据质量则决定了模型能否好用。Stanford CRFM研究指出:训练数据中仅10%的“脏数据”就可能导致模型主任务表现下降30%以上。因此,高质量数据不只是合规要求,更是模型性能的基石。
当前较成熟的数据质量校验手段包括:
数据去重与一致性检查:剔除重复或近似重复数据,避免模型过拟合;
语言逻辑与事实校验:利用事实库和知识图谱识别事实错误或逻辑矛盾;
偏见与毒性检测:识别其中的性别、种族、地域偏见或仇恨性言论,避免生成有害内容。
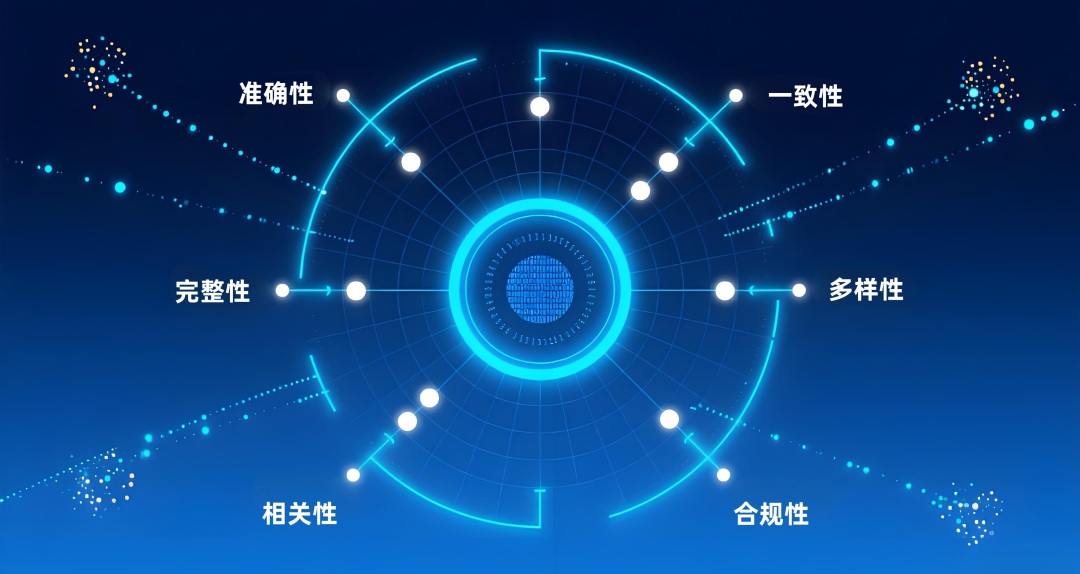
此外,也有企业将质量评估标准体系化,从内容完整性、语言可读性、事实准确性等维度建立打分机制,为模型训练“择优录取”提供参考。
TalkingData在多年数据智能业务中,沉淀了标准化的数据质量评估体系,可从“结构完整性、语义清晰度、逻辑一致性、商业适配度”等维度,为训练数据打分评级,辅助企业按需构建高精度训练集。
FOUR
实战启示:构建数据资产“可信链条”
面向未来,大模型的发展越来越像一场“数据竞赛”。但只有在版权、质量、安全三道关口都“守得住”,才能真正实现技术的可持续创新。
企业在落地大模型相关业务时,可遵循以下实战原则:
01
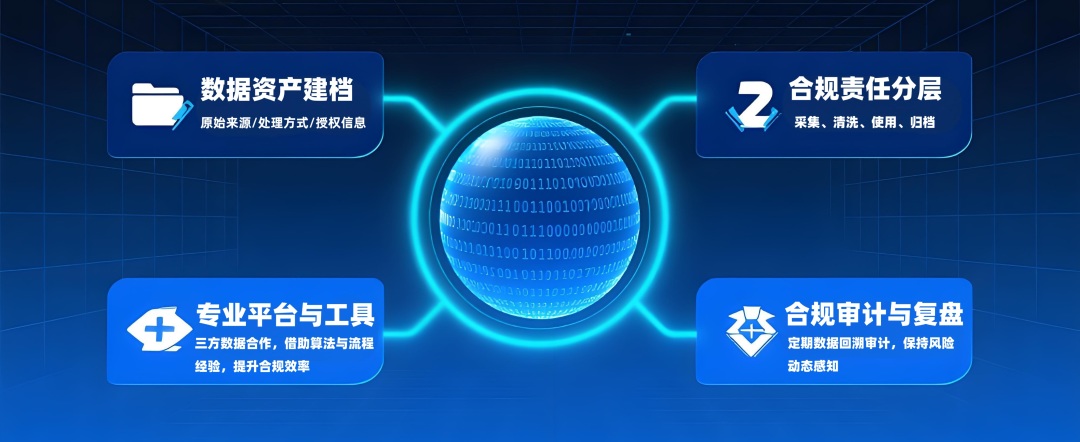
数据资产建档:为每份训练数据建立原始来源、处理方式、授权信息的元数据档案;
02
合规责任分层:将数据处理流程切分为采集、清洗、使用、归档四阶段,分阶段设置合规检查点;
03
引入专业平台与工具:与第三方数据治理服务商合作,借助其算法与流程经验,提升合规效率;
04
开展合规审计与复盘:定期对已用数据进行回溯审计,尤其针对开源数据集,保持风险动态感知。
数据合规
不只是“免责”之举,更是“领先”之道
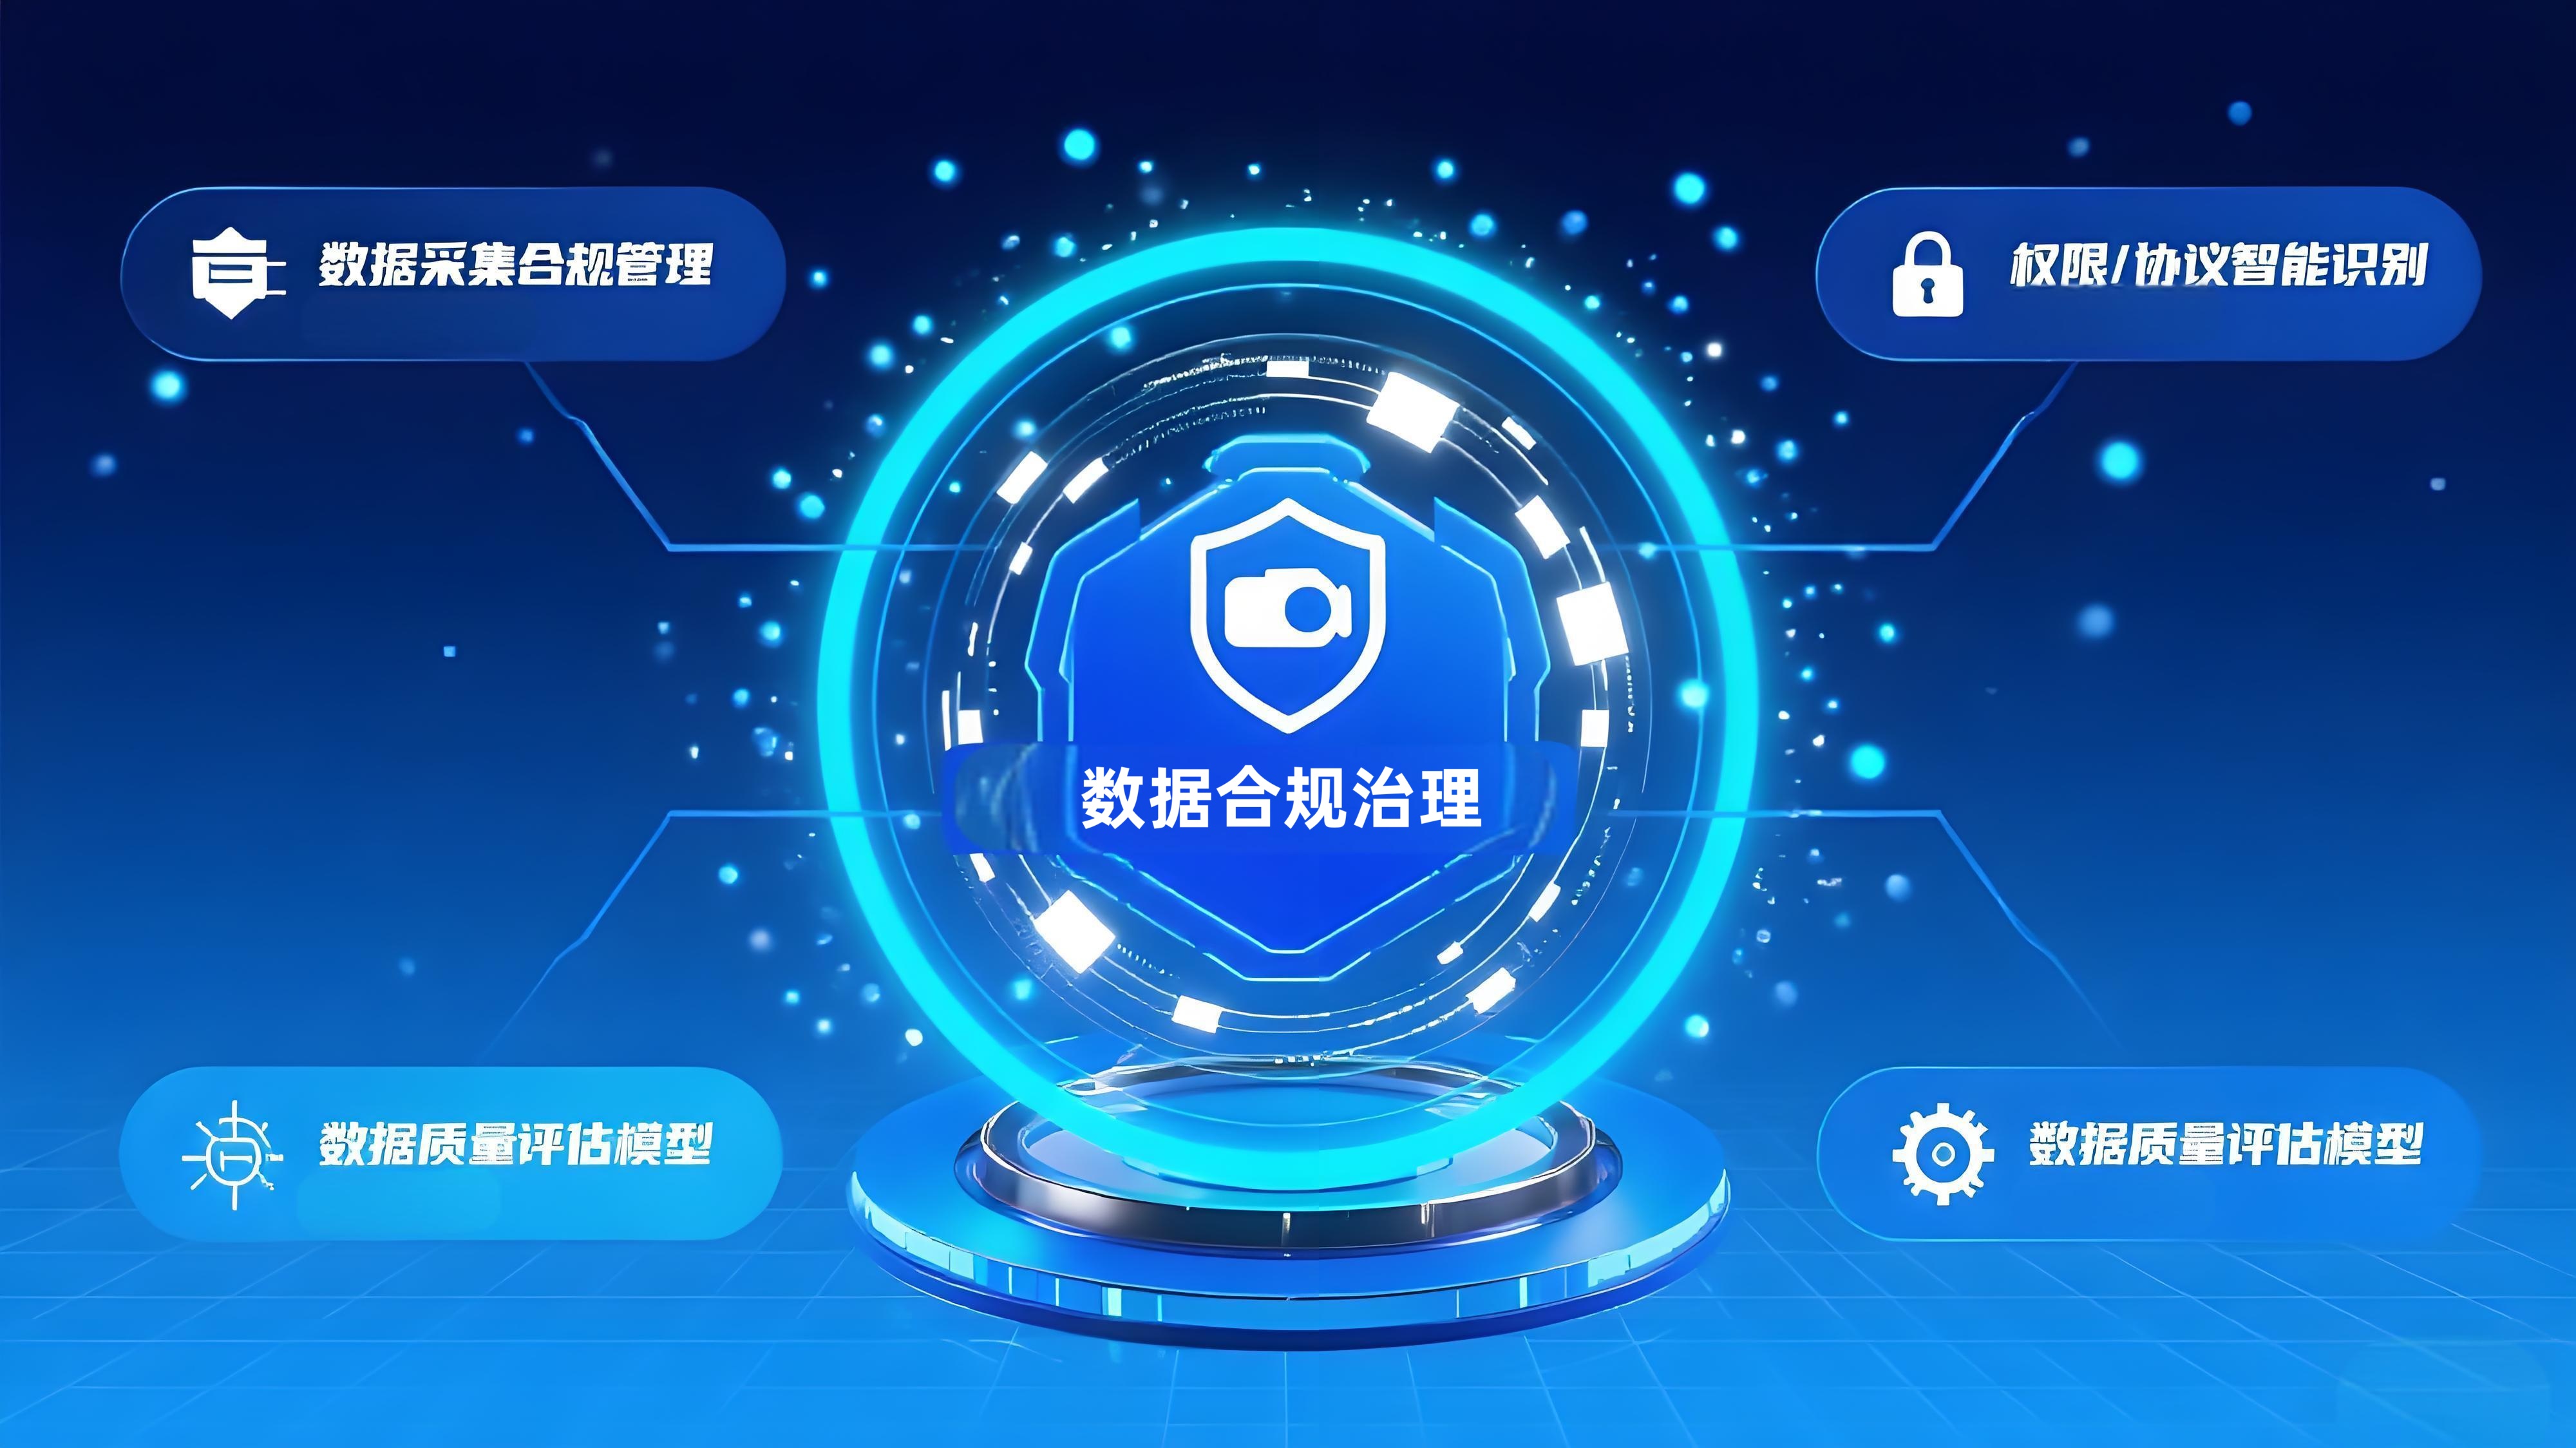
大模型的竞争表面上是算法之争,本质上是数据治理能力之争。在监管不断强化、版权意识觉醒的当下,越早构建起结构清晰、权属明晰、质量可靠的数据资产体系,越有可能在AI时代占据优势。
数据不是“大炼钢”的材料堆,而是每一个AI系统的“第一性原理”。唯有建立起“合规先行、质量为本”的数据资产能力,才能真正释放大模型的商业潜能。
END
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享