过去十年,人工智能的发展仿佛一场“军备竞赛”,大家比拼的是更庞大的模型、更昂贵的算力和更复杂的算法。
但进入 AI 2.5时代,情况正在发生变化:模型的边际改进越来越小,算力也不再是无限扩张的答案。行业逐渐意识到,真正决定 AI 能否落地和创造价值的,不是模型参数有多少,而是 数据是否足够高质量。
换句话说,数据已从“辅助资源”变成了“核心生产力”。
什么样的数据才算“高质量”?
行业内越来越多的共识在于:
高质量数据集的价值,
不在于“大”,而在于“精”。
“
PART 1
高质量数据集的五大特征
真实性:来源清晰,可追溯,避免“虚假样本”污染模型。
多样性:覆盖足够的语言、行为、场景,减少模型的偏差与歧视。
精细度:经过合理清洗和标注,使数据结构化、带标签,使模型能够快速学习。
合规性:符合隐私保护和知识产权要求,安全可用。
价值导向:更重要的是,它必须面向价值,不是为了“能训练”,而是能够支撑行业应用的“真问题”。
在这样的标准下,数据不再是“随手可得的原料”,而是需要长期投入和体系建设的战略资产。
PART 2
从“原料”到“资产”:
数据的全流程治理
构建高质量数据集,并不是单一环节的突破,而是一个系统工程。它往往从合规采集开始,跨越清洗、标注、治理、训练,最终在业务场景中实现价值化。
在采集环节,合法合规成为底线;在清洗阶段,去重、去噪、统一格式,保证数据纯净;在标注过程中,既需要行业专家的深度参与,也需要智能工具提升效率;治理环节则是“质检”,通过偏差校正和样本均衡,确保数据不偏不倚;而在训练和应用环节,数据会不断反馈、迭代,真正形成“价值闭环”。
这个流程像一条“数据生产线”,只有每一个环节都严丝合缝,最终才能产出真正有价值的数据资产。
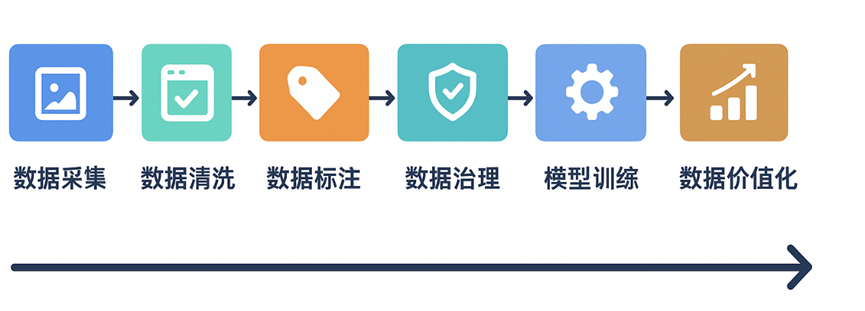
数据全流程治理
采集:多源数据接入(行为、交易、传感器、文本等),同时确保合法合规。
清洗:去重、去噪、统一格式,消除冗余。
标注:结合专家知识与智能工具,实现语义理解、场景标注。
治理:数据质量检测、偏差校正、样本均衡。
训练:将数据与模型耦合,不断迭代。
价值化:应用于实际业务,形成闭环反馈。
对于企业来说,问题已不仅仅是“是否要做 AI”,而是“如何构建属于自己的高质量数据集”。
答案有三:
只有从实际应用出发,反推数据集建设方向,才能避免盲目投入。医疗需要医学语料,金融需要合规交易数据,零售需要用户行为链路——数据和业务之间必须紧密耦合。
AI 2.5 时代,模型和算力的比拼正在趋于平稳,但数据质量的竞争才刚刚开始。谁能率先掌握高质量数据集,谁就能在行业智能化的浪潮中站在前列。
这不仅仅是一场技术博弈,更是一场生态竞争。未来的 AI,不是比谁有更大的模型,而是比谁有更强的“数据力”。
END
高质量数据集是未来AI 发展的支撐。
为人工智能提供所需的一切数据
#Data AI# #万亿数据要素市场#
推荐阅读:

TalkingData
用数据优化决策、加速转型
欢迎关注分享